

AI 摘要
- NVIDIA RTX Spark 把代理式 AI 帶進 Windows 11 平台。
- 平台與 DGX Spark 共用 GB10 SoC,最高支援 128 GB 記憶體。
- Pair 可在區域網路內把 AI 工作分配給不同裝置。
NVIDIA 在 RTX Spark Editor’s Day 活動中說明 RTX Spark 平台的 AI 功能。這個平台最大的特色,是支援 Windows 11 作業系統與應用程式,讓熟悉 Windows 生態系的創作者與開發者,能在既有遊戲、創作與生產力軟體基礎上,疊加代理式(agentic)與生成式 AI 體驗。NVIDIA 本機 AI 與遊戲平台副總裁 Jason Paul 親自出席活動,說明該平台在 AI 功能上的設計取向。
從 DGX Spark 到 RTX Spark:同一顆 GB10,換上 Windows
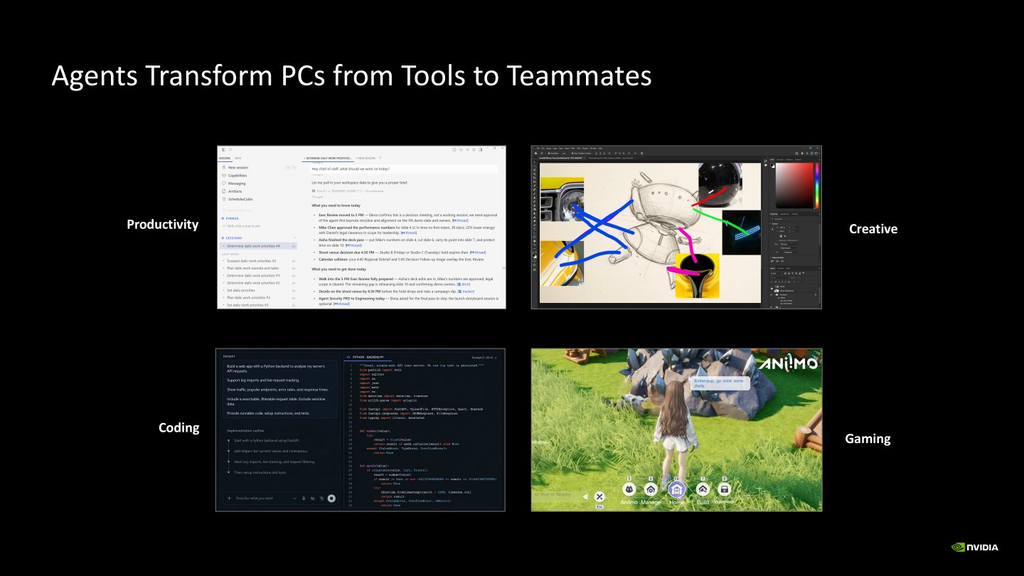
依 NVIDIA 的定義,代理式 AI 對硬體的需求並不只是算力。除了需要效能較高的 GPU(繪圖處理器)與 NPU(神經處理器)以滿足 AI 運算,還需要核心數較多的 CPU,以便 AI 代理主動操作各種傳統應用程式;由於可能同時執行多款參數量較高的模型,對記憶體容量的需求也相對提高。
NVIDIA 先前的 DGX Spark 平台能滿足上述要件,但目前僅支援 Linux 作業系統。AMD 則以代號 Strix Halo 的 Ryzen AI Max+ 395 等處理器,憑藉 x86 架構 CPU、規模更大的內建 GPU 與支援 128 GB 記憶體等條件,較早把代理式 AI 體驗帶進 Windows 生態系。
RTX Spark 平台採用與 DGX Spark 相同的 GB10 SoC,同樣最高支援 128 GB 記憶體,主要差異在於作業系統由 Linux 遷移至 Windows 11。NVIDIA 表示,這讓使用者能在既有 Windows 使用習慣上,直接加入本機端的代理式 AI 能力。
| 平台 | 作業系統 | 核心硬體 | 記憶體 |
|---|---|---|---|
| NVIDIA RTX Spark | Windows 11 | GB10 SoC | 最高 128 GB |
| NVIDIA DGX Spark | Linux | GB10 SoC | 最高 128 GB |
| AMD Ryzen AI Max+ 395(Strix Halo) | Windows 生態系 | x86 架構 CPU 搭配規模更大的內建 GPU | 支援 128 GB |
降低導入門檻:Windows Get Started 與 Built 範例
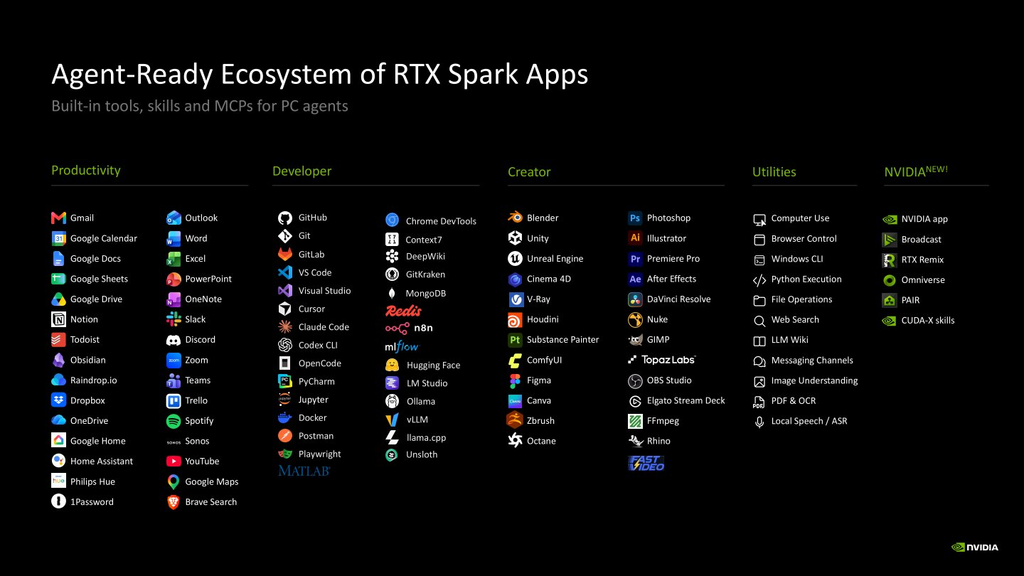
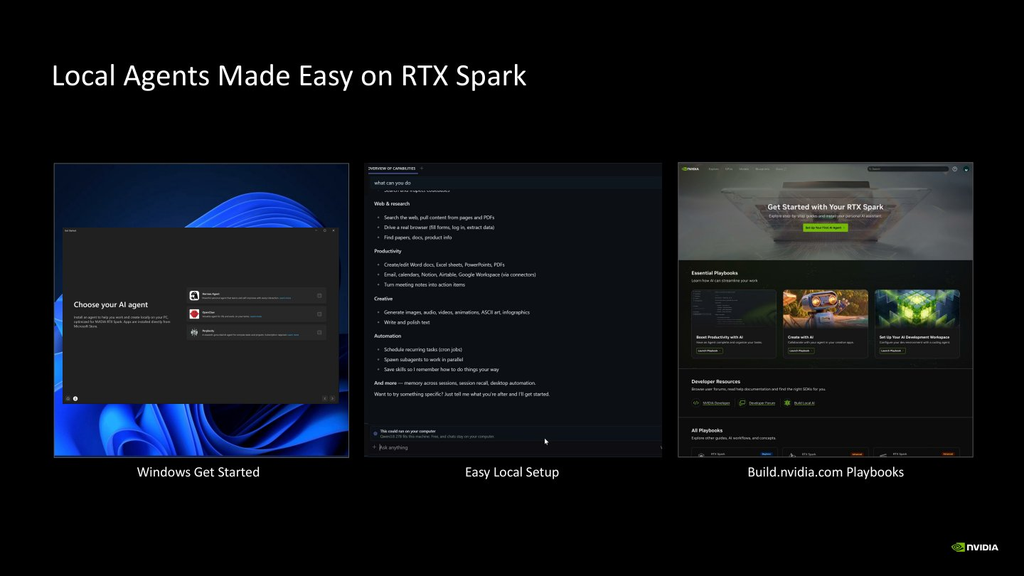
安裝與設定向來是本機 AI 的門檻之一。NVIDIA 與 Microsoft 合作,透過 Windows Get Started、Easy Local Setup 等程式引導使用者快速安裝多種 AI 軟體;NVIDIA 也在 Built 網站上提供應用範例,以降低進入門檻。來源指出,RTX Spark 的代理式 AI 可支援多款生產力、多媒體創作、程式開發與工具程式,以及 NVIDIA 自家 App。
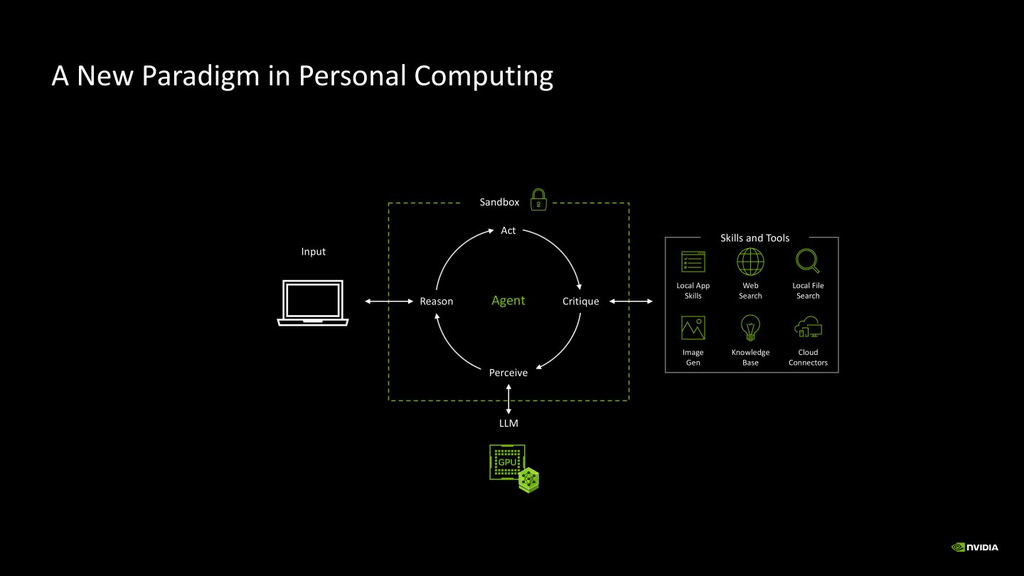
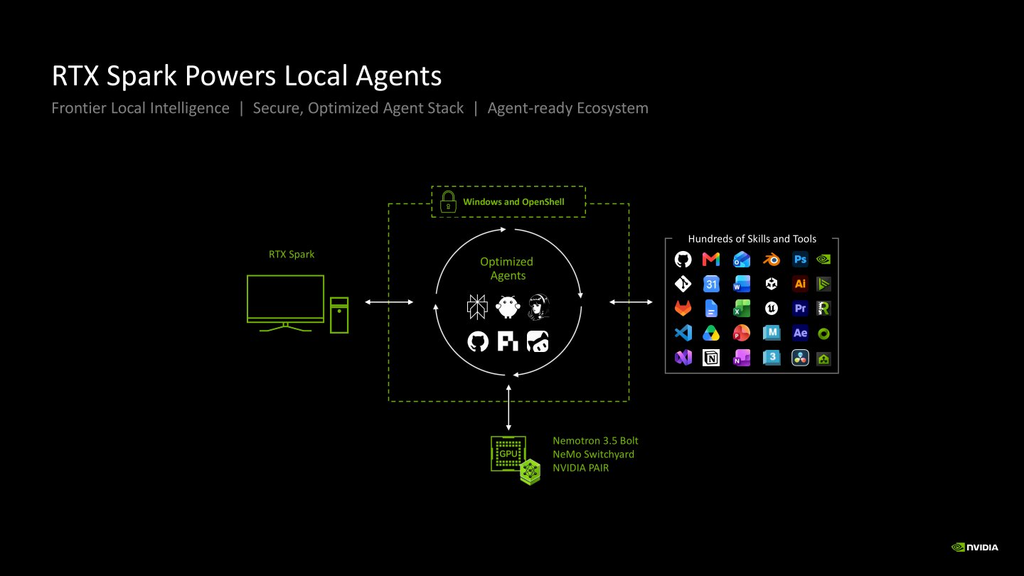
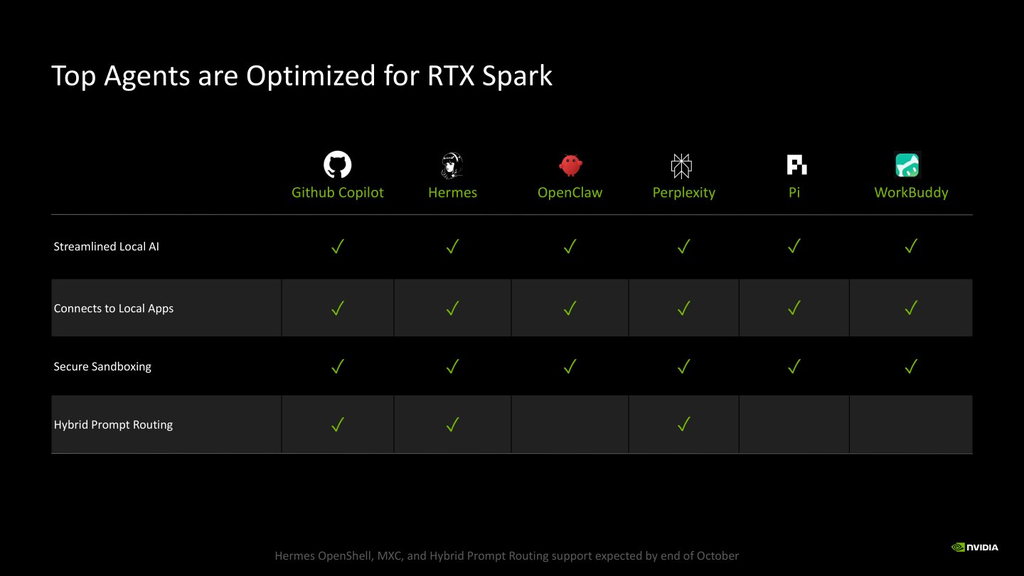
在框架層面,平台支援 Github Copilot、Hermes、OpenClaw、Perplexity、Pi、WorkBuddy 等多款代理式 AI 框架,可串連本機 AI 與應用程式,並提供安全沙盒環境,部分框架另支援雲端混合運算。AI 代理可透過 MCP(Model Context Protocol,模型上下文協定)自動操作生產力、多媒體創作、程式開發與遊戲等應用軟體。
安全架構:OpenShell 執行環境與 MXC 容器
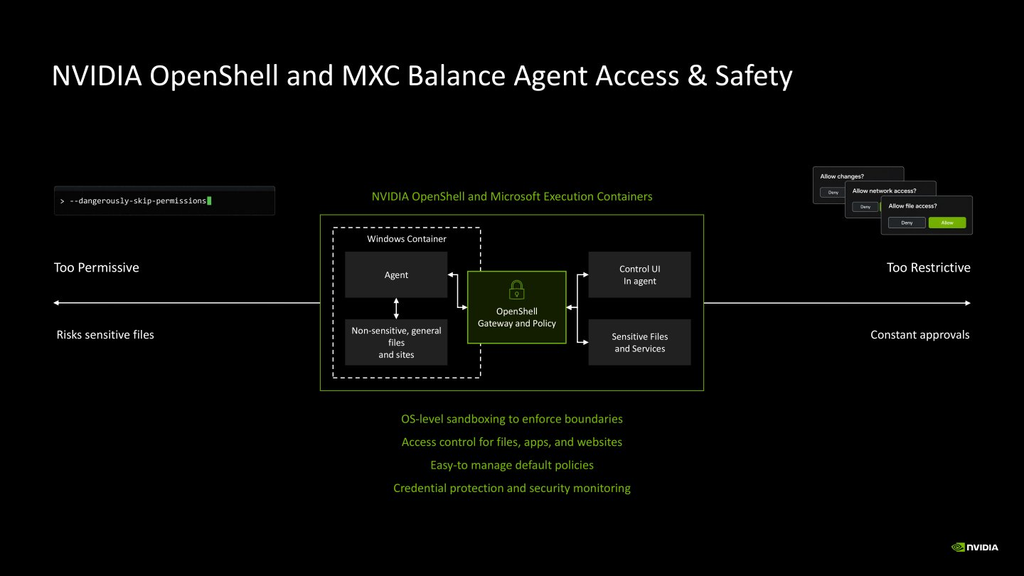
讓 AI 代理操作本機應用程式,權限管理是核心風險。NVIDIA 提供便於管理的 OpenShell 執行環境,採正向表列(allowlist)的權限管理方式,預設封鎖所有 AI 代理的操作,需經確認後才開放權限;其設計是把安全性綁定在執行環境,而非 AI 模型或應用程式本身,以取得更可控的資安防護。
Microsoft 方面推出 MXC 容器(Microsoft eXecution Containers,微軟執行容器),建立作業系統層級的隔離式沙盒,讓 AI 代理在沙盒中運作,便於管理檔案、App 與網路資源的存取權限與管理策略,並提供更強的資安防護與監測。NVIDIA 表示,代理式 AI 會在安全的沙盒環境中進行「感知、推理、行動、評斷」等工作,並透過技能(Skill)與外部工具自動執行更多元的工作。
成本對比:本機推論與雲端 API 的差距
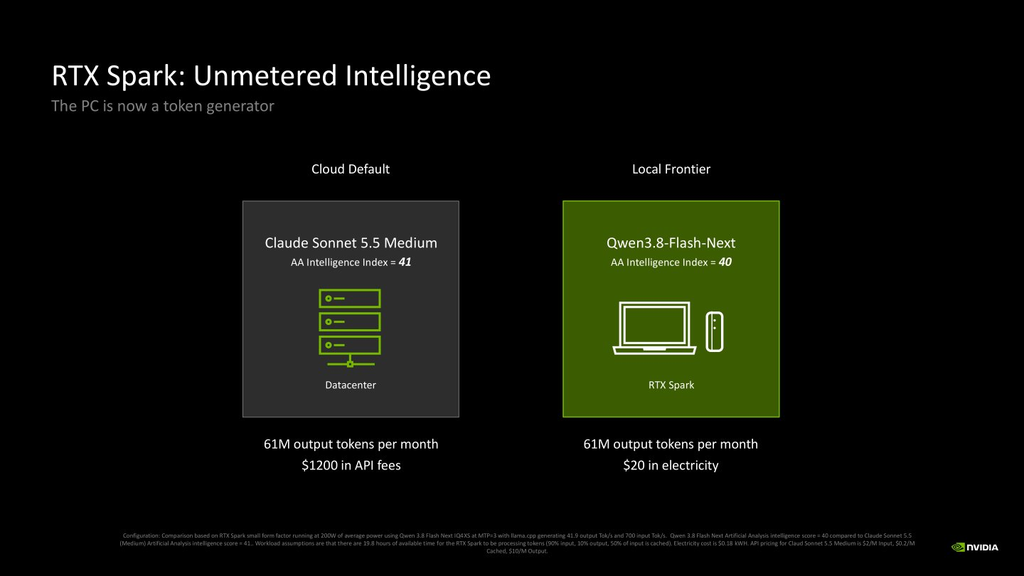
會中展示的一組比較,說明本機執行代理式 AI 的成本結構。2026 年 4 月時,雲端資料中心透過 Claude Sonnet 4.7 Max 模型在 Artificial Analysis Intelligence Index 測試取得 41 分;到了活動當時,Claude Sonnet 5.5 Medium 可得到同樣分數,而在本機端執行的 Qwen 3.8-Flash-Next 則取得接近的 40 分。
在同樣每月輸出 6,100 萬組 Token(字詞)的情況下,NVIDIA 提供的數字如下:
| 執行方式 | 代表模型 | Intelligence Index 分數 | 每月 6,100 萬 Token 成本 |
|---|---|---|---|
| 雲端 API | Claude Sonnet 5.5 Medium | 41 | 約美金 1,200 元 |
| RTX Spark 本機 | Qwen 3.8-Flash-Next | 40 | 約美金 20 元電費 |
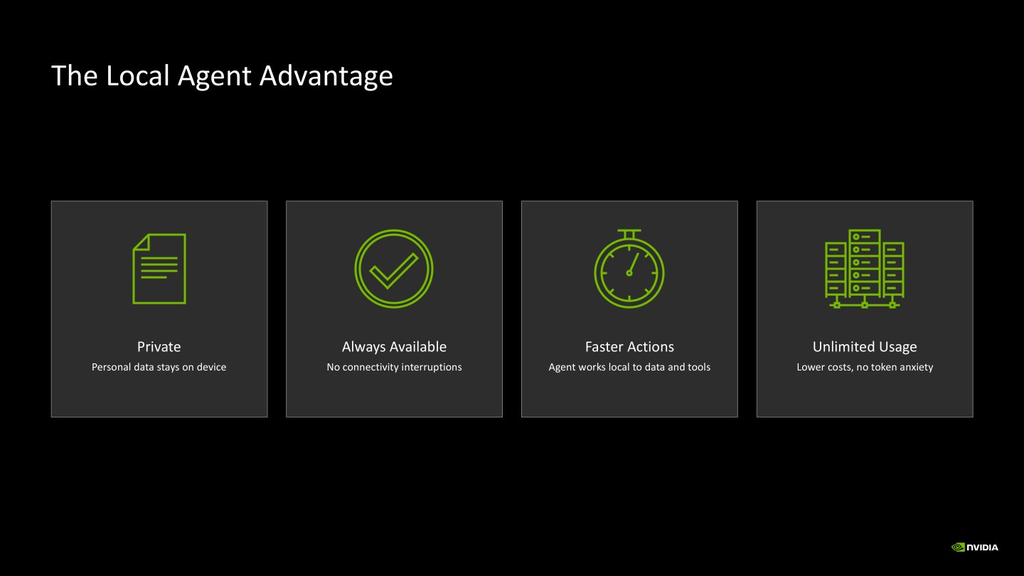
需注意的是,這是 NVIDIA 自行提出的比較情境,測試分數差距、模型選擇與用電估算皆有其前提,並非通用基準。不過它點出本機 AI 的主要訴求:資安隱私、快速反應、常時可用與用量不受雲端計費限制。
NeMo Switchyard:本機優先,雲端補位
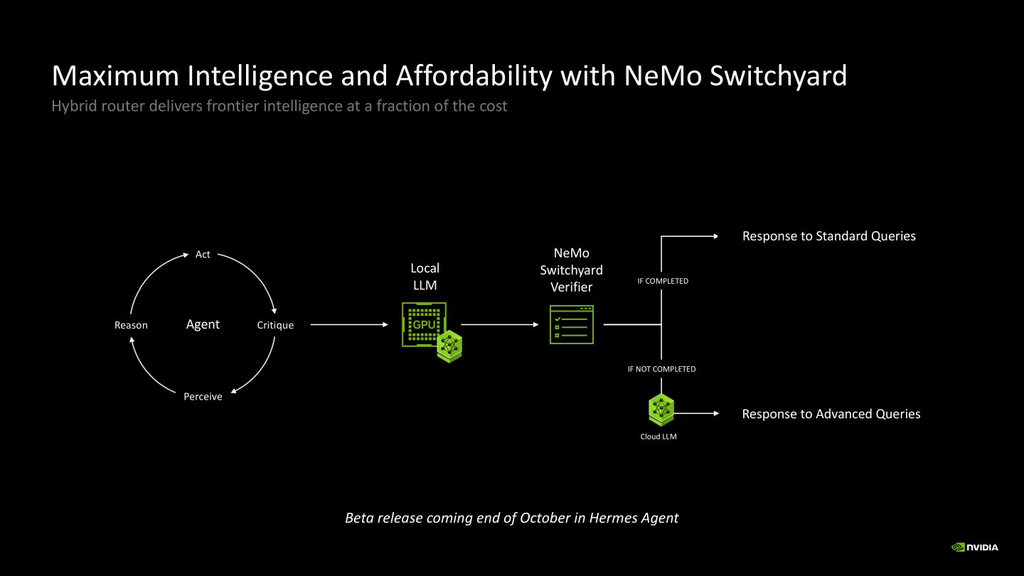
NeMo Switchyard 是一款混合雲端與本機的函數庫,能自動判別本機大語言模型的推論品質:若通過門檻即採用本機結果以節省費用,若未通過則將需求上傳至雲端處理。後者會產生 Token 使用費,但可換得更精準的結果。這種設計等於把「夠用就好」的工作留在本機,把難題交給雲端。
Pair 路由:把家庭區域網路變成 AI 運算池
NVIDIA 同時推出適合家庭區域網路環境的 Pair 路由功能,支援 Windows、Linux 與 macOS,推出時即支援 Ollama 與 LM Studio 等運算框架。Pair 可將 AI 運算負載分配到區域網路中的 DGX Spark、RTX Spark、搭載 GeForce RTX 顯示卡或顯示晶片的 Windows 電腦,以及 macOS 裝置等節點,達到分散式運算與資源調度效果。
依 NVIDIA 的說明,Pair 的運作特性包括:
- 將 AI 推論負載分配至區域網路中的閒置節點,不受節點作業系統限制。
- 可跨平台搬移工作,例如把 Windows 電腦上 Ollama 框架產生的負載,轉移至執行 Linux 的 DGX Spark 運算。
- 資料僅在本機端或區域網路內交換,避免隱私或機敏資料外流。
活動現場以動態方式展示 Pair:當區域網路中任一台電腦發出工作需求,系統會自動把負擔分配至最適合的節點完成運算並回傳結果。展示影片中可見多個不同運算負載被分配到三個節點分頭處理。
不過 Pair 有一項明確限制:它只能把多個工作分配給不同裝置,無法將單一工作拆分為多個部分進行分配。也就是說,它提升的是整體吞吐量與資源利用率,而非讓多台機器協同加速同一個推論任務。
限制與待觀察事項
就目前揭露的資訊,RTX Spark 的定位是把 DGX Spark 的本機 AI 能力移植到 Windows 11,硬體架構變動有限,價值主要在生態系與軟體堆疊。幾項關鍵問題尚待更多實測:代理式 AI 透過 MCP 操作實際應用程式時的穩定度與錯誤率、OpenShell 與 MXC 雙層權限與沙盒機制在真實工作流程中的可用性、Pair 在混合 Windows 與 macOS 節點時的延遲表現,以及本機模型在複雜任務上與雲端模型的實際落差。
來源未提供 RTX Spark 的售價、各市場上市時間與完整機型清單,相關資訊仍待 NVIDIA 後續公布。
後續
此篇為 RTX Spark Editor’s Day 系列報導之一,後續將介紹 RTX Spark 的創作相關功能,並預計進行代理式 AI 實測。
Reference Link : techbang.com