

AI 摘要
- 馬斯克旗下團隊正式發佈新一代大型語言模型 Grok 4.7。
- 新模型透過延長強化學習週期,重點強化長任務執行與自我檢查能力。
- API 標準定價為每百萬輸入 2 美元、輸出 6 美元,僅約競爭對手三分之一。
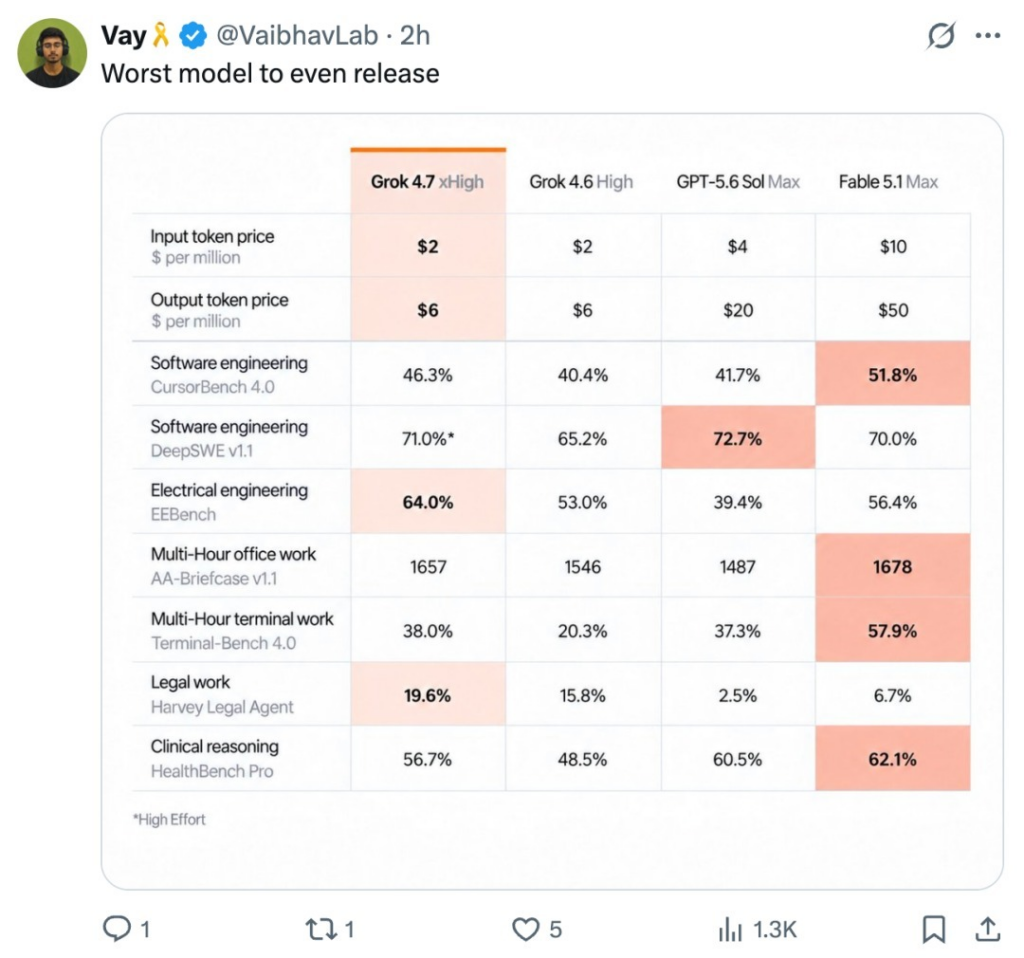
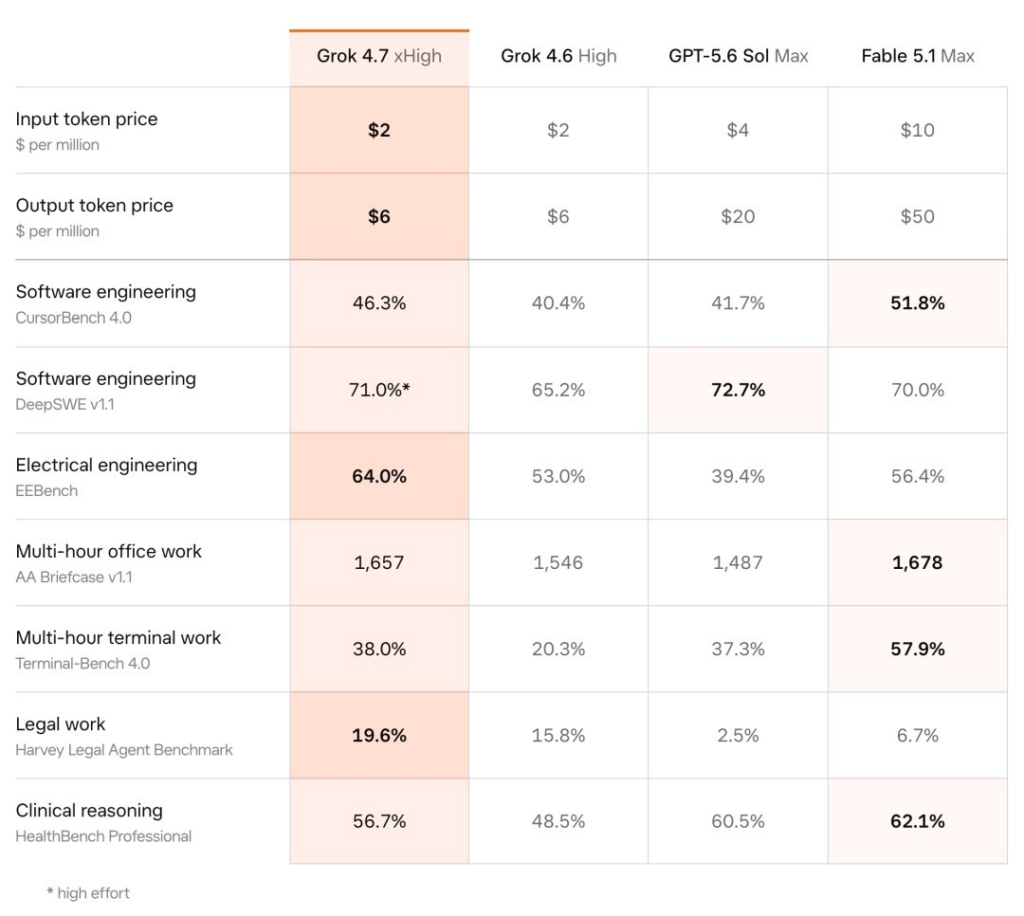
馬斯克旗下人工智慧團隊正式發佈新一代旗艦大型語言模型 Grok 4.7。這款新模型將核心技術焦點轉向自主代理人(AI Agent)架構與極長工作流程,主打在長時間的程式碼建置、專案除錯及跨模組修改中不當機、不產生目標漂移,並以每百萬輸入 Token 僅 2 美元、輸出 6 美元的定價進軍市場,呼叫成本僅為同級競爭對手的三分之一。
瞄準長任務與自主代理人:延長強化學習訓練週期
隨著軟體工程全面轉向自主代理人作業,AI 模型面臨的考驗已從局部的程式碼補全,升級為動輒數小時的複雜專案管理。代理人必須自主閱讀整體代碼庫(Repository)、拆解架構需求,並在命令列環境中反覆進行編譯與測試。為了解決漫長思考鏈中的幻覺與重試成本,Grok 4.7 採用更大體積的基礎模型,並在預訓練與對齊階段大幅拉長強化學習(Reinforcement Learning)週期,將需耗時數小時的棘手任務納入訓練,建立極嚴格的自我檢查(Self-checking)機制與長上下文管理能力,同時原生支援 Grok Bot 運行架構。
基準測試數據:程式開發與跨領域專業成果比較
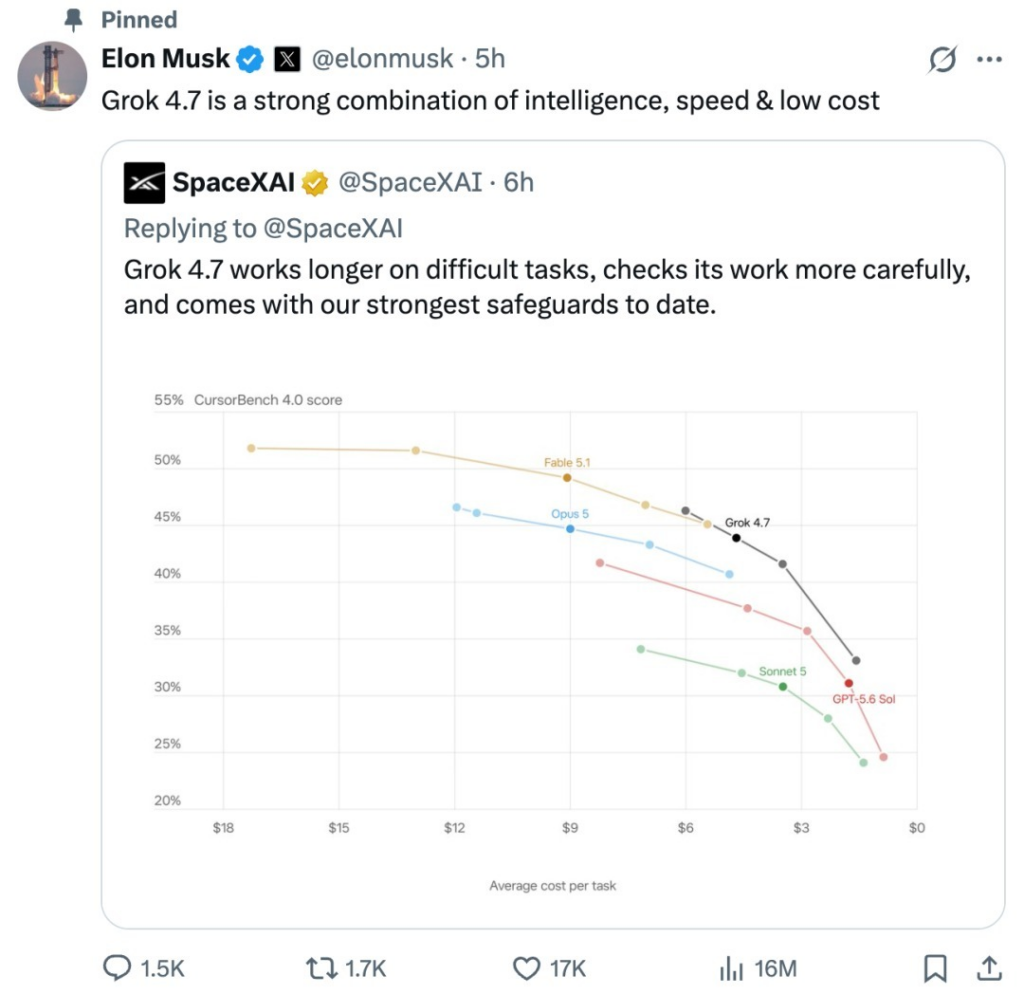
在專門考核長時間程式開發與多小時終端操作的測試中,Grok 4.7 展現了相較前代顯著的效能躍升;同時在法律、醫療、電機等專業工作交付評測中,亦繳出亮眼表現。
| 評測項目 / 指標 | Grok 4.7 | 前代 Grok 4.6 / 對照模型 |
|---|---|---|
| CursorBench 4.0(長時間程式開發) | 46.3% | 40.4%(Grok 4.6) |
| Terminal-Bench 4.0(多小時命令列環境操作) | 38.0% | 20.3%(Grok 4.6) |
| DeepSWE v1.1(深層推理) | 71.0% | 未提供 |
| AA-Briefcase v1.1(多步驟專業工作成果) | 1657 分(分析品質 1994 Elo) | 1546 分(Grok 4.6) |
| GDPval(實際工作成果生成) | 1695 Elo | 1542 分(GPT-6 Astra)/ 1735 分(Fable 5.1) |
| EEBench(電機工程) | 64.0% | 53.0%(Grok 4.6) |
| Harvey Legal Agent Benchmark(法律代理人) | 19.6% | 15.8%(Grok 4.6) |
| HealthBench Professional(臨床醫學推理) | 56.7% | 48.5%(Grok 4.6) |
| LatchBio(生物安全基準) | 62.4%(登頂) | 未提供 |
| HackerBench v0.3(高風險雙重用途提示放行率) | 3.3% | 未提供 |
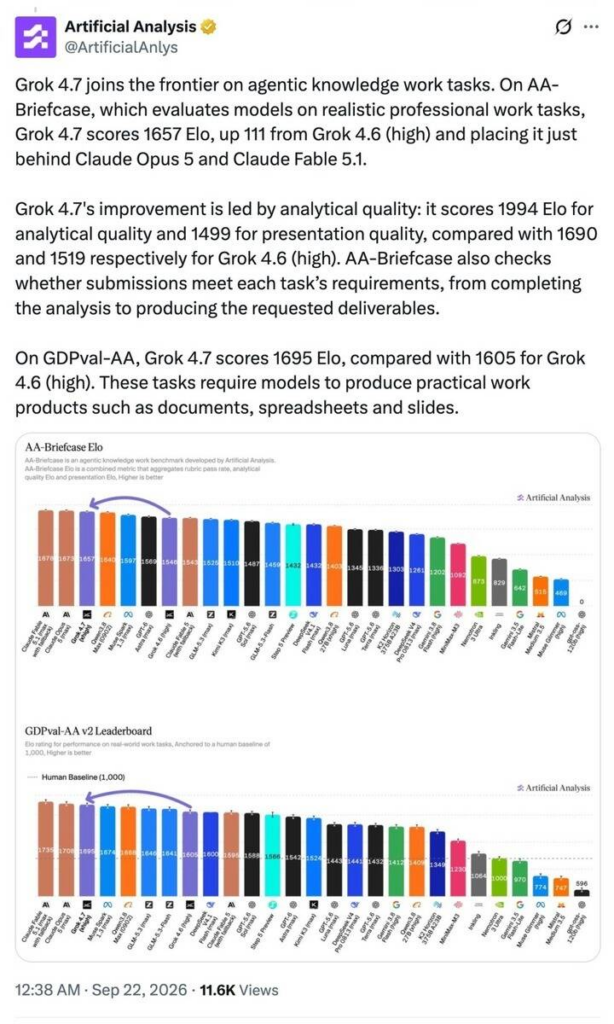
價格與支援平台:高性價比挑戰市場同級旗艦
在生態整合與計費策略上,Grok 4.7 目前已全面進駐 Cursor 與 Grok Build,並開放 API、主流雲端平台與第三方框架調用。其標準版 API 定價維持每百萬輸入 Token 2 美元、輸出 Token 6 美元。相較於競爭對手同級旗艦模型動輒每百萬輸入 10 美元、輸出 50 美元的定價體系,大幅降低了企業與獨立開發者建置複雜工作流時的營運支出。
Reference Link : techbang.com