

AI 摘要
- Intel 推出搭載代號 Panther Lake 的邊緣運算處理器 Intel Core Ultra X7 358H。
- 處理器整合 CPU、GPU 與 NPU 運算單元,具備高性價比並鎖定自主機器人市場。
- 搭配開源 OpenVINO 實體 AI 框架簡化軟硬體部署,正式版預計 2026 年下半年推出。
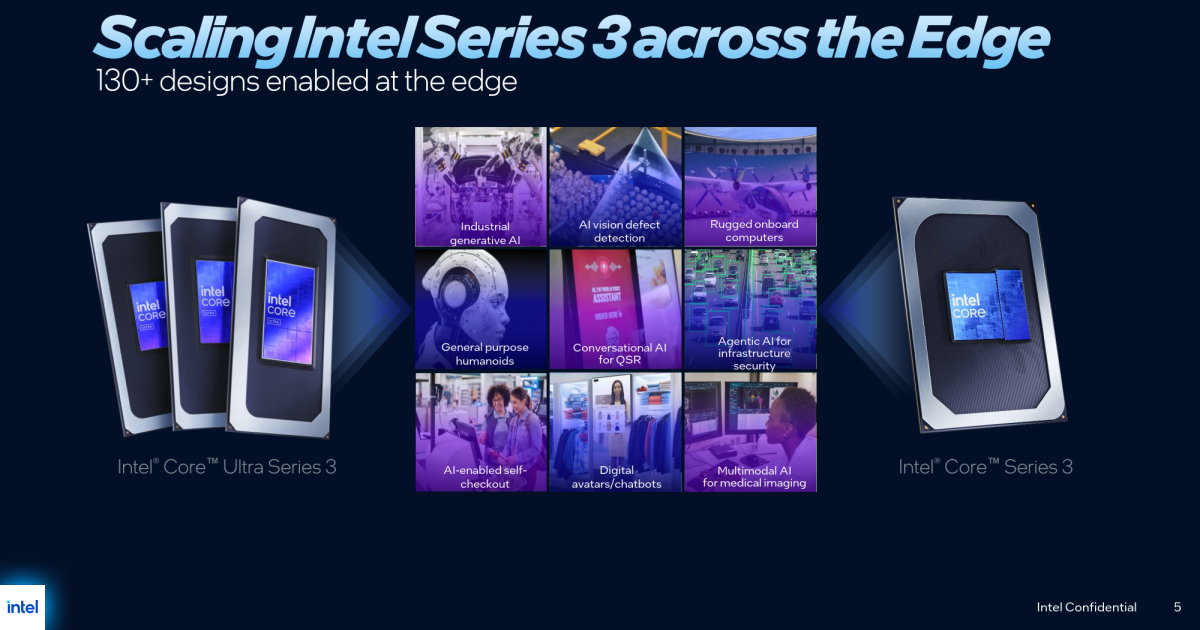
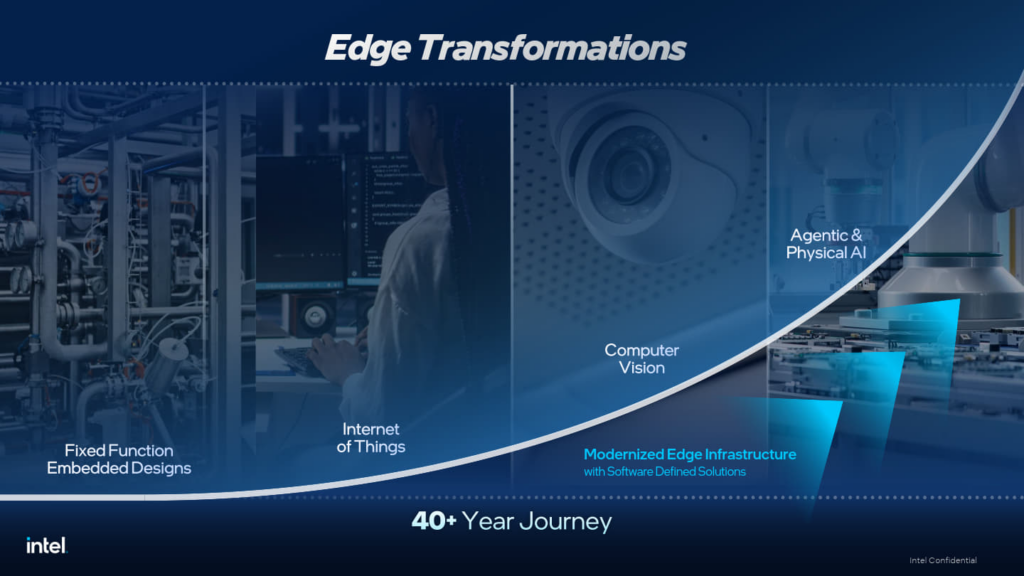
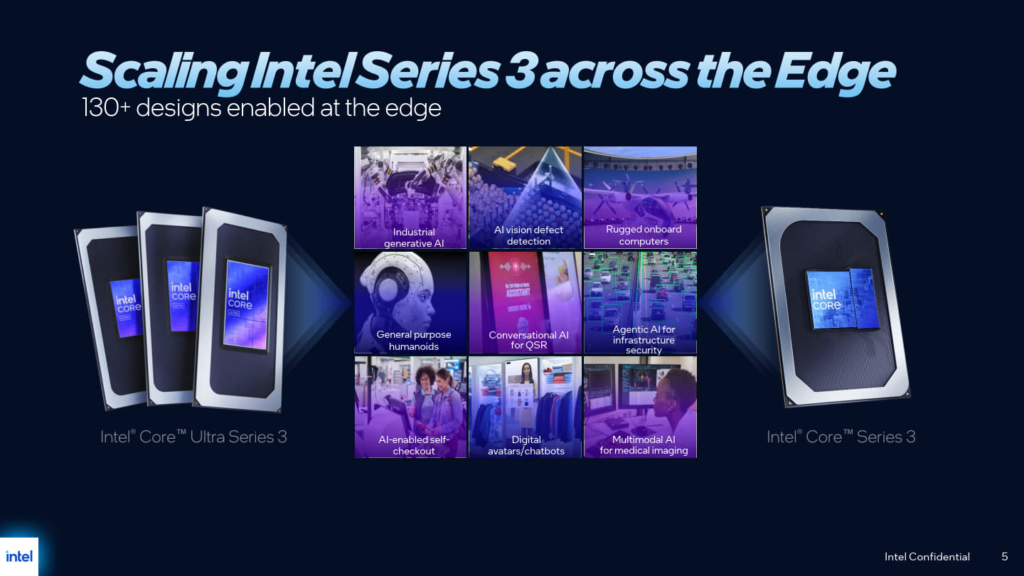
Intel 正式發表搭載代號 Panther Lake 的最新邊緣運算處理器 Intel Core Ultra X7 358H,瞄準自主移動機器人、機械手臂及智慧工業等實體 AI(Physical AI)市場。目前已有超過 130 款邊緣運算裝置設計導入代號 Panther Lake 的 Core Ultra 系列 3 以及代號 Wildcat Lake 的 Core 系列 3 處理器,透過整合式異質架構滿足當前邊緣端對即時電腦視覺與多模態 AI 運算的嚴苛需求。
全方位運算架構與 AI 效能指標
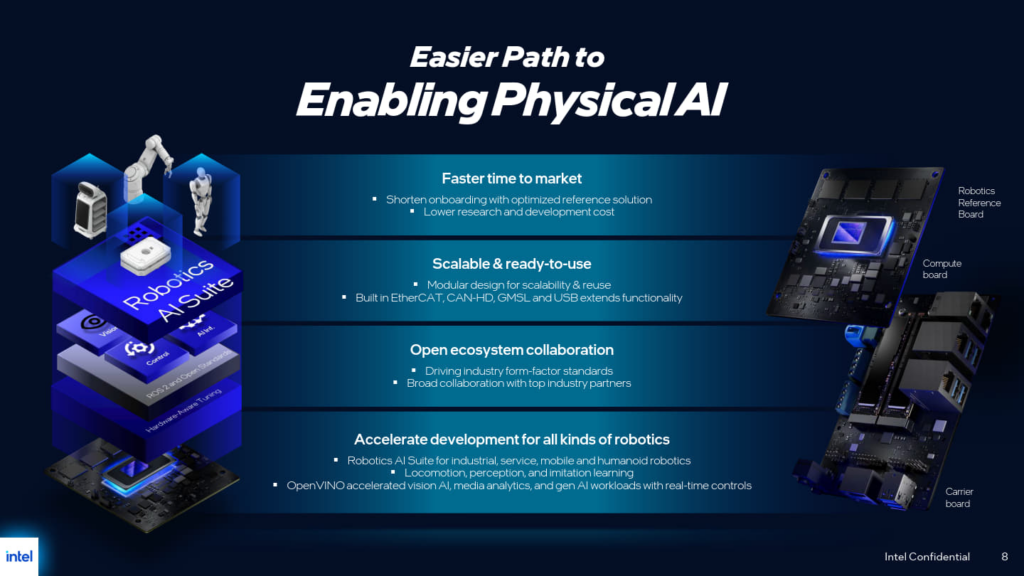
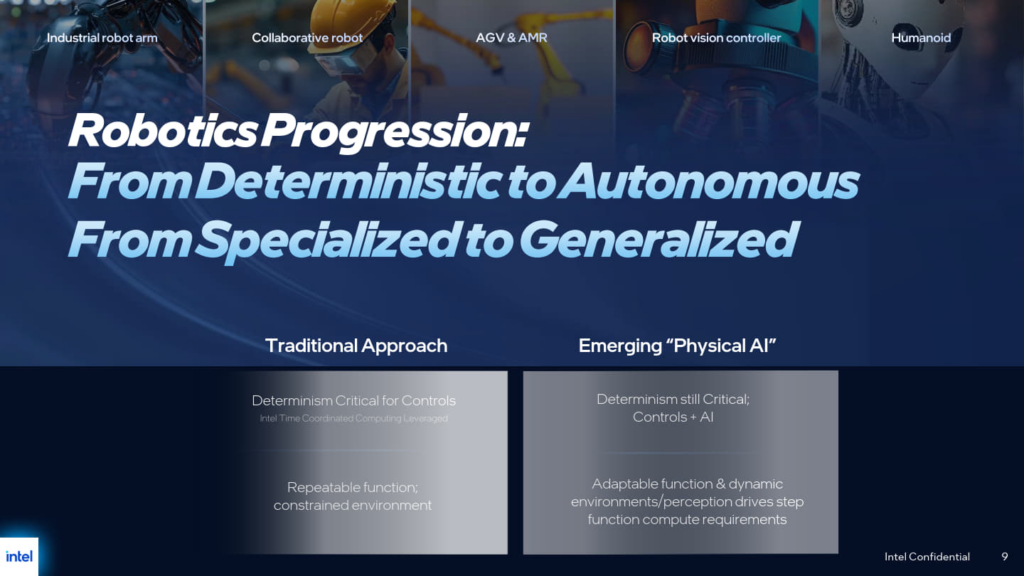
Intel Core Ultra 系列 3 處理器全面整合 CPU、GPU 與 NPU 運算單元。其運算效能表現如下:
- CPU AI 運算效能:最高達 10 TOPS。
- GPU AI 運算效能:最高達 120 TOPS。
- NPU AI 運算效能:最高達 50 TOPS。
此外,處理器內建 IPU 7.5 影像處理器,支援同時連接 3 組 MIPI 介面攝影機或紅外線攝影機,能夠為倉儲機器人、自走車(AMR)、機械手臂及人型機器人等設備提供低延遲、高清晰度的即時影像辨識能力。Intel 亦宣布將推出工控寬溫版本,以適應更嚴苛的工業自動化與智慧城市極端運作環境。
競品架構與規格對比
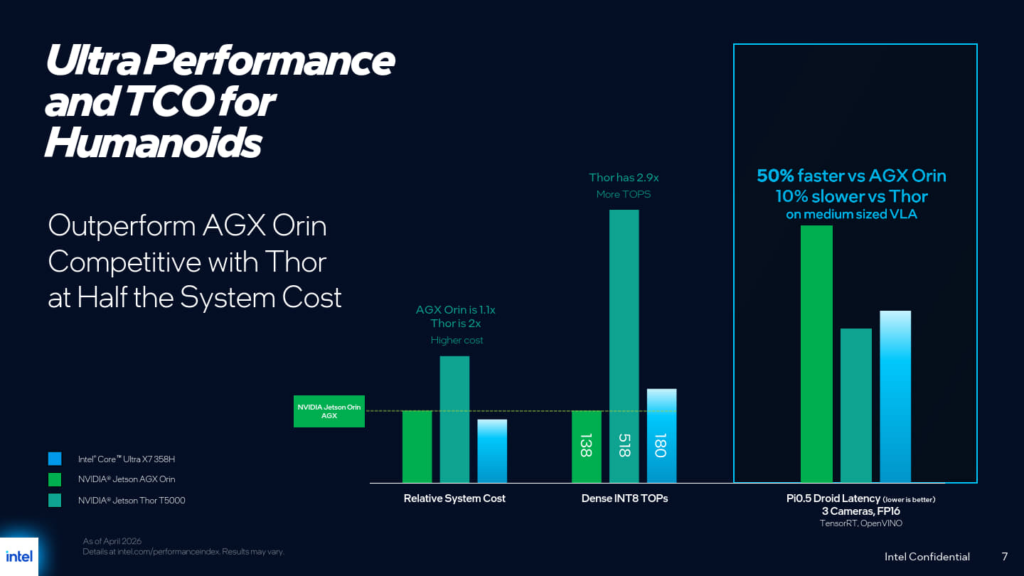
根據官方公佈之數據,Intel Core Ultra X7 358H 面對 NVIDIA 邊緣運算方案展現了高度的系統成本競爭力:
| 比較項目 / 晶片型號 | Intel Core Ultra X7 358H | NVIDIA Jetson AGX Orin / Jetson Thor |
|---|---|---|
| 架構特點 | 整合 CPU、GPU、NPU 及 IPU 7.5 | 專用邊緣 AI 運算模組架構 |
| 系統成本優勢 | 具備較佳的相對系統成本效益 | 系統建置成本相對較高 |
| 3 組攝影機 FP16 Pi0.5 Droid 推論延遲 | 推論延遲僅落後 Jetson Thor 約 10% | 延遲表現領先,但硬體成本顯著較高 |
| 稠密 INT8 AI 運算效能 | 落後 Jetson Thor 幅度較大 | 稠密運算效能具備領先優勢 |
搭配 OpenVINO 實體 AI 框架簡化開發
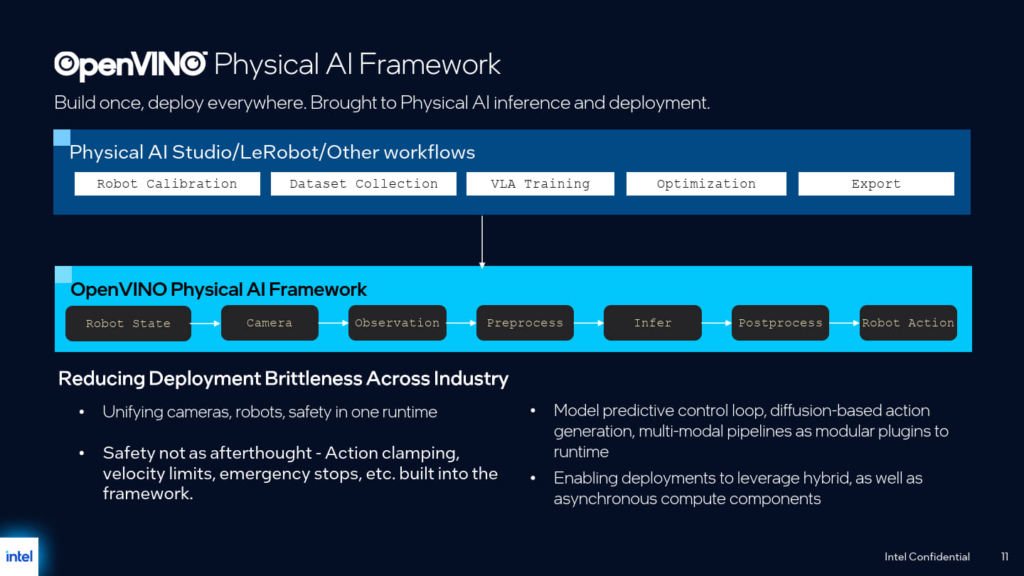
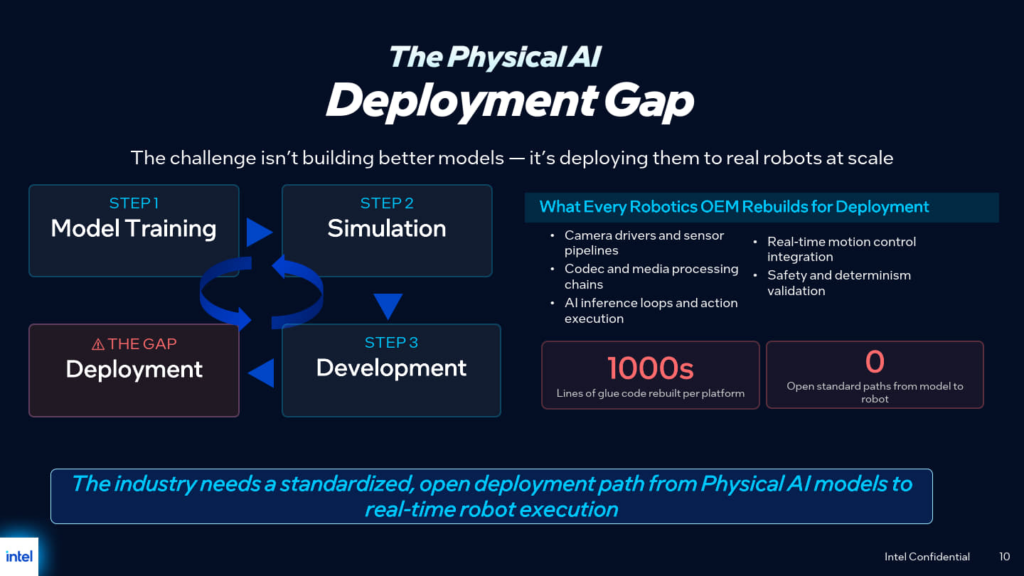
為了解決實體 AI 部署中感測器管線、攝影機驅動程式與動態控制整合的痛點,Intel 推出專為機器人打造的開源推論方案「OpenVINO 實體 AI 框架」與「實體 AI Studio」。此工具支援與 LeRobot 等開源生態整合,並提供資料收集、模型微調、量化與預先驗證功能,幫助企業降低總體持有成本(TCO)並加速機器人編隊規模化部署。目前該框架預覽版已於 GitHub 提供,正式版本預計於 2026 年下半年推出。
Reference Link : techbang.com