

AI 摘要
- OpenAI推出程式評測基準MultiLangBench,檢驗模型使用20種程式語言從頭構建SQLite資料庫引擎的能力。
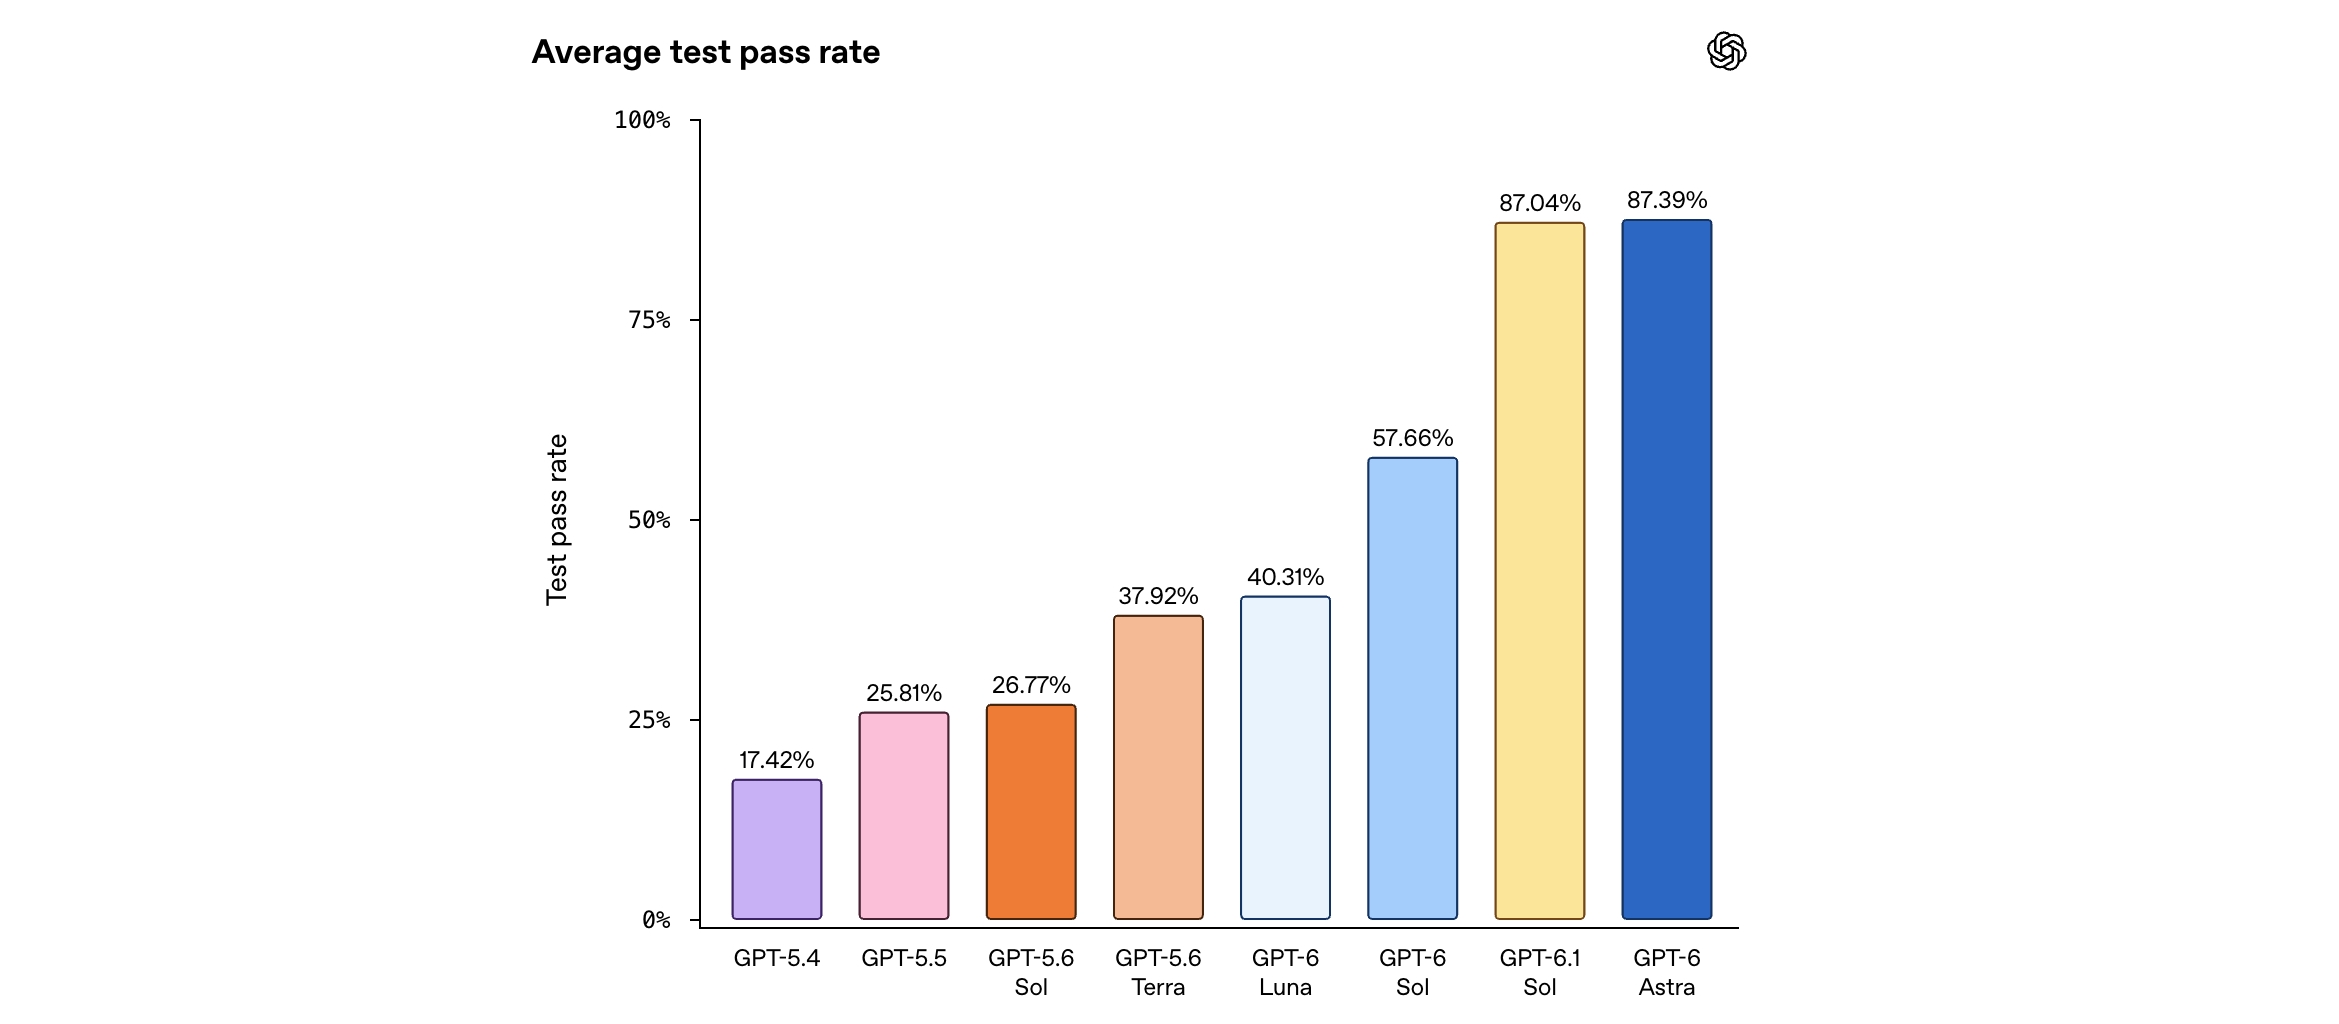
- 評測涵蓋COBOL、Fortran與Python等語言,GPT-6 Astra在最高推理強度下平均通過率達87.4%。
- 針對老舊系統現代化設計COBOL改寫任務,GPT-6.1 Sol取得86.6%準確率,相關測試資料已在GitHub開源。
人工智慧研究機構OpenAI正式公開全新程式開發基準測試MultiLangBench,旨在嚴格檢驗AI模型是否具備使用20種不同程式語言、從頭構建與SQLite相容資料庫引擎的工程能力。此項基準測試不僅涵蓋Python、Java與Rust等現代主流語言,更納入COBOL、Fortran與Visual Basic等訓練資料與文件相對匱乏的傳統語言,為評估大型語言模型在老舊系統維護、軟體現代化以及跨語言移植等企業級任務提供全新衡量標準。
解決企業現代化痛點:老舊系統維護與跨語言移植
許多運作數十年的企業核心系統仍高度依賴COBOL等早期語言。然而,隨著原始開發人員退休離職及規格文件缺損,關鍵業務邏輯往往僅封存在舊程式碼中。AI雖能輔助維護與遷移,但若無法精確理解既有業務規則(例如特定數值的截斷或捨入處理),將導致計算結果失真。由於COBOL、Fortran及Visual Basic可供AI訓練的資源遠少於熱門語言,過往模型在處理此類任務時經常遭遇瓶頸,促使OpenAI推出MultiLangBench進行系統化驗證。
嚴格測試機制:離線環境實現SQLite相容引擎
MultiLangBench以SQLite 3.40.1作為統一測試題目,要求受測模型僅依據提供的技術文件,使用指定的程式語言從零開發出可執行資料庫查詢與修改指令的完整程式。為確保測試公正性,測試環境具備以下技術限制:
- 完全離線隔離:測試過程全面禁止存取網際網路,防止模型查詢外部即時解答。
- 移除既有軟體:執行環境中會預先移除現成SQLite軟體,避免模型直接呼叫或套用現成二進位檔。
- 精確結果核對:系統將模型生成的程式所產生的執行結果,與原版SQLite比對驗證,確保邏輯與輸出百分之百相符。
模型效能實測表現與技術指標
在OpenAI公布的基準評測中,搭載不同推理設定的模型展現出明顯效能差異。在最高推理強度下,GPT-6 Astra在20種程式語言的平均測試通過率達87.4%,大幅超越GPT-5.6 Sol的26.8%。即便在最難以處理的COBOL項目中,GPT-6 Astra亦取得了72.1%的通過率。
| 評測模型 | 測試情境 / 任務 | 推理強度 | 測試結果表現 |
|---|---|---|---|
| GPT-6 Astra | 20種語言平均通過率 | 最高推理強度 | 87.4% |
| GPT-5.6 Sol | 20種語言平均通過率 | 最高推理強度 | 26.8% |
| GPT-6 Astra | COBOL SQLite引擎構建 | 最高推理強度 | 72.1%(該模型表現最低項目) |
| GPT-6.1 Sol | COBOL跨語言改寫評測 | 較低推理強度 | 86.6%準確率 |
專屬COBOL改寫測試與開放原始碼資源
除了從零構建引擎,OpenAI亦設計了專門的COBOL改寫評測,要求模型將COBOL舊程式準確轉換為C++、Java、Kotlin、Python或Rust,並著重驗證業務細節的保真度(例如金額運算中捨去小數與四捨五入的差異)。在此專項測試中,GPT-6.1 Sol在較低推理強度下繳出86.6%的改寫準確率。目前OpenAI已在GitHub正式釋出MultiLangBench的基準測試設定與測試資料,供全球開發者與研究人員自行驗證與評測。
Reference Link : ithome.com.tw