

AI 摘要
- TypeSafe AI發布決策型AI模型Jev 1.14.0,獨家新增Box物件定位功能並開放圖片輸入分析。
- 實驗性長上下文功能將單次請求上限提升至26.2萬詞元,支援Jev 1.14.0與Jev 1.13。
- 內部評測顯示Jev 1.14.0綜合分數為60.0分,多語言能力有所提升,現可透過jev-preview存取。
美國AI新創公司TypeSafe AI正式發布決策型AI模型Jev 1.14.0,同步開放圖片輸入與長上下文等實驗性功能。新版本最大亮點在於加入獨家「Box」物件定位功能,能直接回傳座標與信心分數,協助應用程式快速執行影像結構化分析與後續自動化決策。不過,官方也提醒影像相關功能目前仍處於實驗階段,尚未達到正式環境的可靠度要求。
決策型架構專注結果輸出:圖片輸入與比對功能解密
與一般逐字生成文字的對話模型不同,TypeSafe AI設計的Jev模型專注於決策任務。開發者在輸入資料與問題後,模型會直接回傳是非判斷、分類選項或評分,並附帶機率資訊以利程式自動執行後續動作。在影像能力方面,開發者可將圖片加入API請求中,與文字一併作為分析資料、指令或分類基準。例如提供一張參考圖片,要求模型比對另一張照片是否包含相同物件,或是依據範例進行分類。此圖片輸入功能同時支援Jev 1.13與新版Jev 1.14.0。
Jev 1.14.0獨家Box物件定位功能
作為Jev 1.14.0獨有的新特色,「Box」功能可辨識並定位圖片中的特定物件,例如照片中的杯子或掃描文件上的簽名位置。模型會回傳物件外框的上下左右座標(數值介於0至1之間),便於程式換算實際像素位置。需要注意的是,每個Box問題僅會回傳單一外框,即便目標物件未出現也會產生座標,因此官方建議搭配是非判斷功能,先確認物件存在再取用座標。
上下文上限提升至26.2萬詞元
除了視覺分析外,TypeSafe AI亦開放長上下文實驗性功能。在預設情況下,單次請求上限為6.4萬詞元,單一問題連同共用資料上限為3.2萬詞元;而在API標頭手動啟用長上下文後,兩項上限皆提升至26.2萬詞元。雖然擴展能容納更多文件資料,但官方表示這可能會增加處理時間並略為降低判斷準確度。此長上下文功能同樣向下支援Jev 1.13。
版本功能與技術指標對比
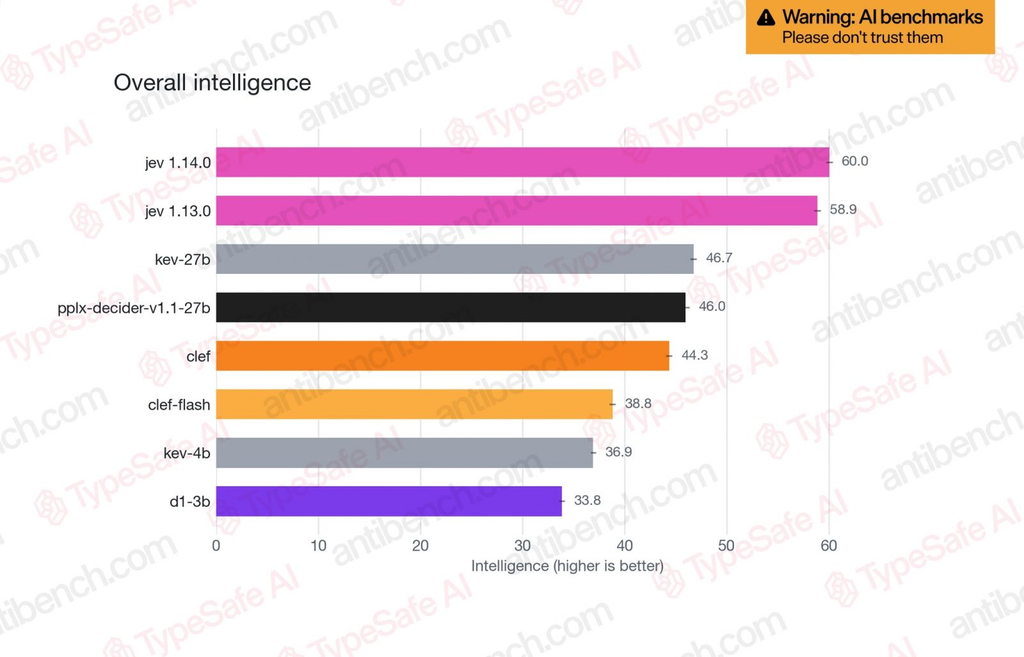
在內部評測中,Jev 1.14.0綜合分數達到60.0,相較於前代Jev 1.13的58.9略有改善,尤其在多語言能力上有較明顯進步。目前開發者已可透過jev-preview存取Jev 1.14.0,預計發布約一周後,jev-latest標籤將全面切換至新版本。
| 功能 / 規格項目 | Jev 1.13 | Jev 1.14.0 |
|---|---|---|
| 圖片輸入與比對分析 | 支援 | 支援 |
| Box 物件定位功能 | 不支援 | 支援(回傳0至1外框座標與信心分數) |
| 預設請求詞元上限 | 6.4萬詞元 | 6.4萬詞元 |
| 實驗性長上下文上限 | 最高26.2萬詞元(需標頭啟用) | 最高26.2萬詞元(需標頭啟用) |
| 內部評測綜合分數 | 58.9 | 60.0 |
| 取得管道 | API 穩定版 | jev-preview(約一周後切換至 jev-latest) |
Reference Link : ithome.com.tw