

AI 摘要
- 聯想 YOGA Pro 15 RTX Spark 首發搭載台積電 3nm 製程 NVIDIA N1X 晶片,整合 20 核 CPU、6,144 CUDA GPU 與 128GB 統一記憶體。
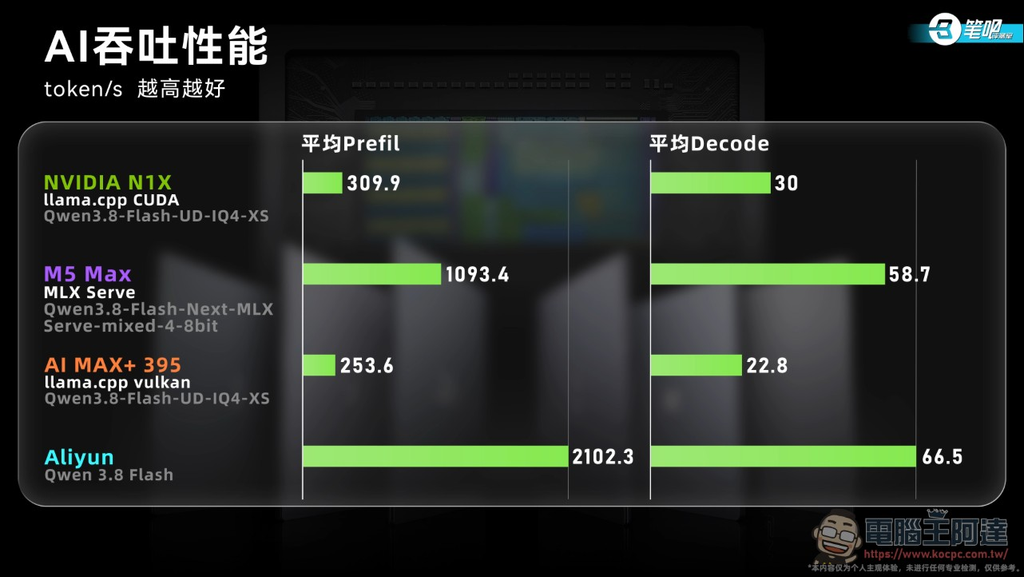
- 本地 AI 表現突出,預填充與解碼速度較 Ryzen AI MAX+ 395 提升逾兩成,並原生支援 llama.cpp 框架。
- 受限於 80W 功耗與 Windows on ARM 轉譯損耗,遊戲與 x86 傳統應用效能顯著折損,軟體相容性仍在過渡期。
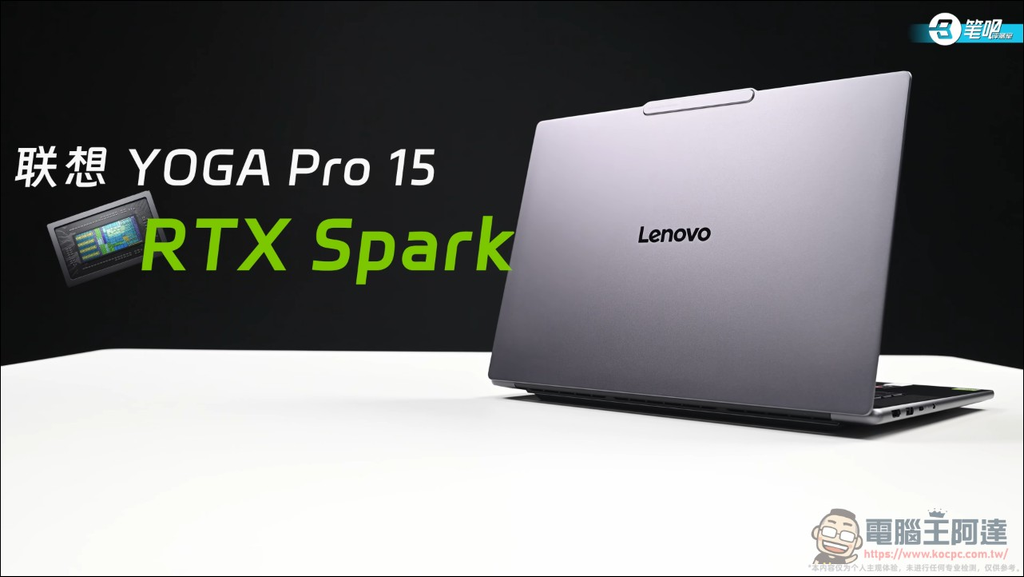
NVIDIA 於 5 月底發表的 RTX Spark 超級晶片正式迎來首波市售硬體,定位為個人 AI 電腦的聯想 YOGA Pro 15 RTX Spark 成為全球首批搭載第一代 N1X 晶片的旗艦機型。該機採用 SoC 架構,整合 Grace CPU、Blackwell 架構 GPU 及超大容量統一記憶體,鎖定本地 AI 運算、高階創作與開發者族群。評測室針對滿配版本展開完整實測,深入探討其本地 AI、圖形運算、遊戲相容性以及整機機構表現。
雙 Die 台積電 3nm 製程:N1X 超級晶片架構與規格剖析
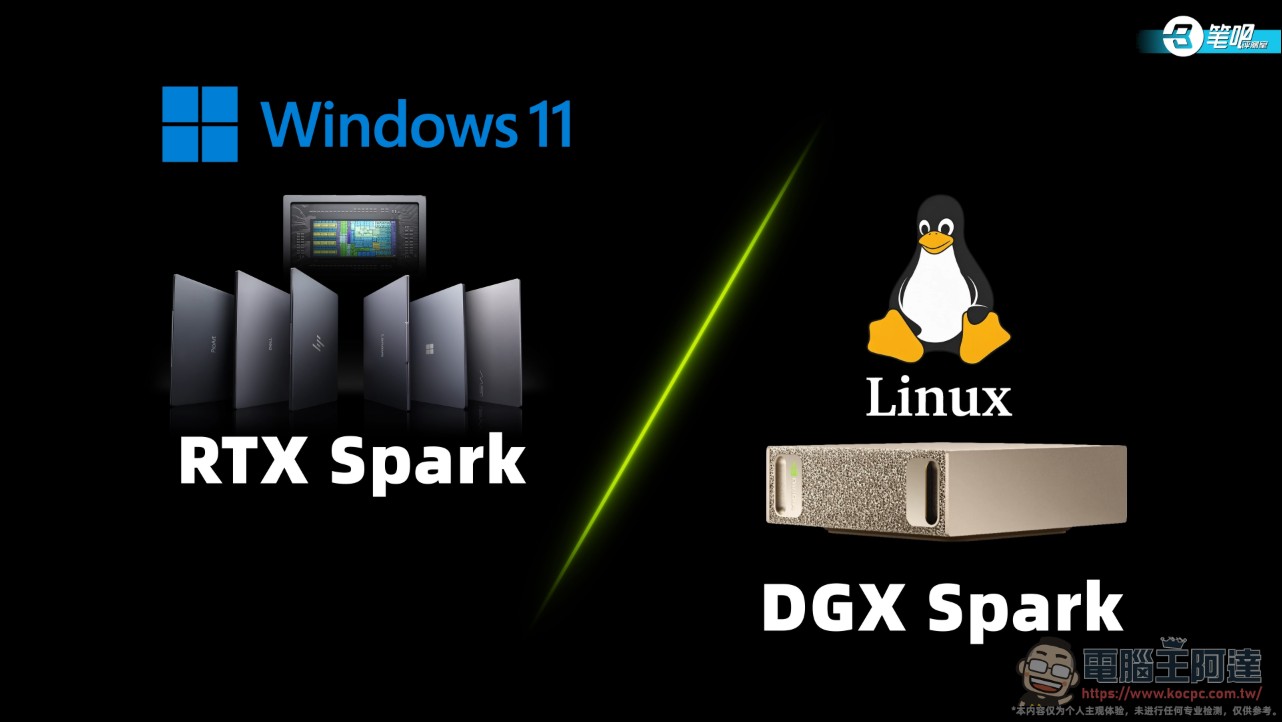
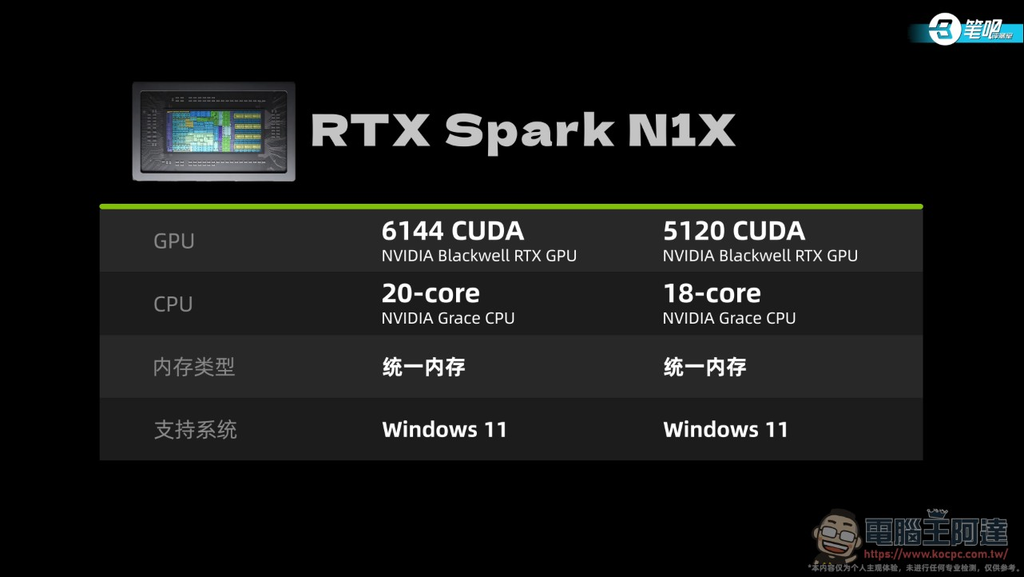
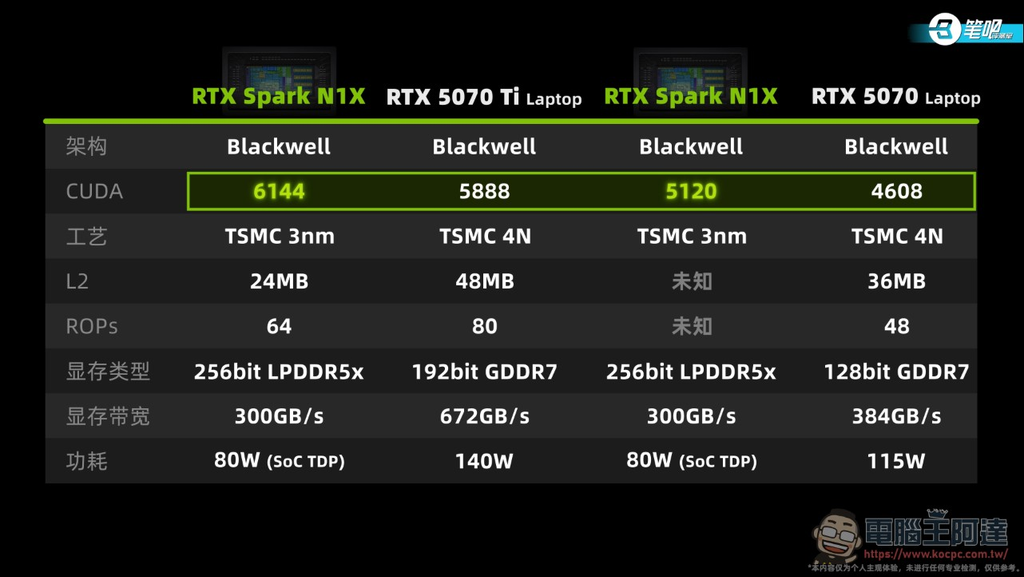
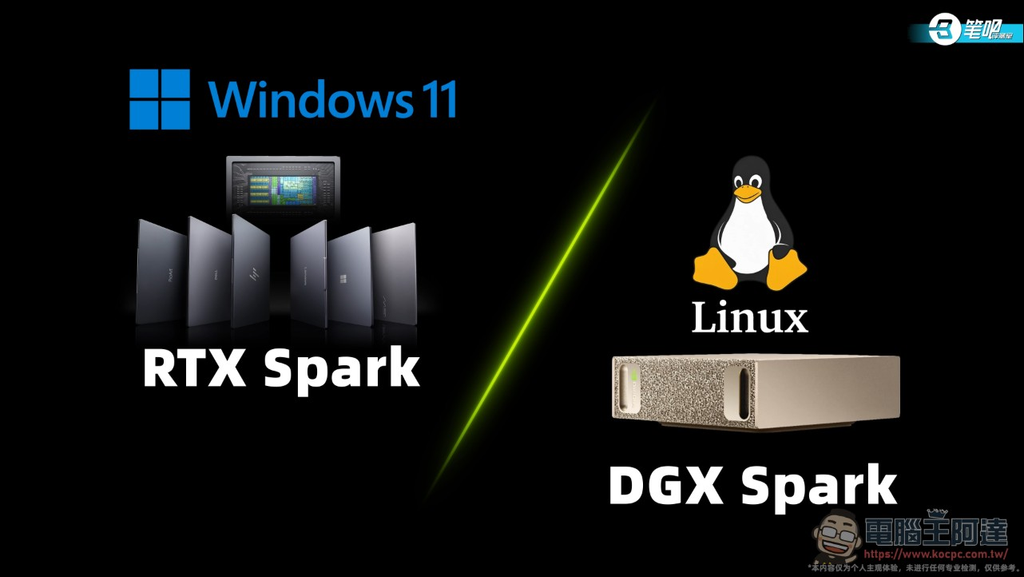
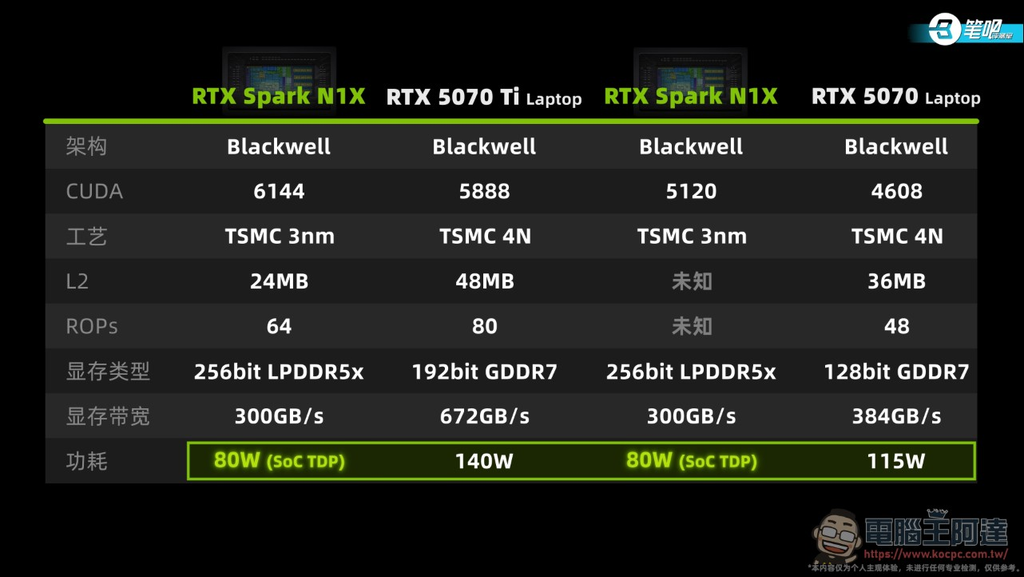
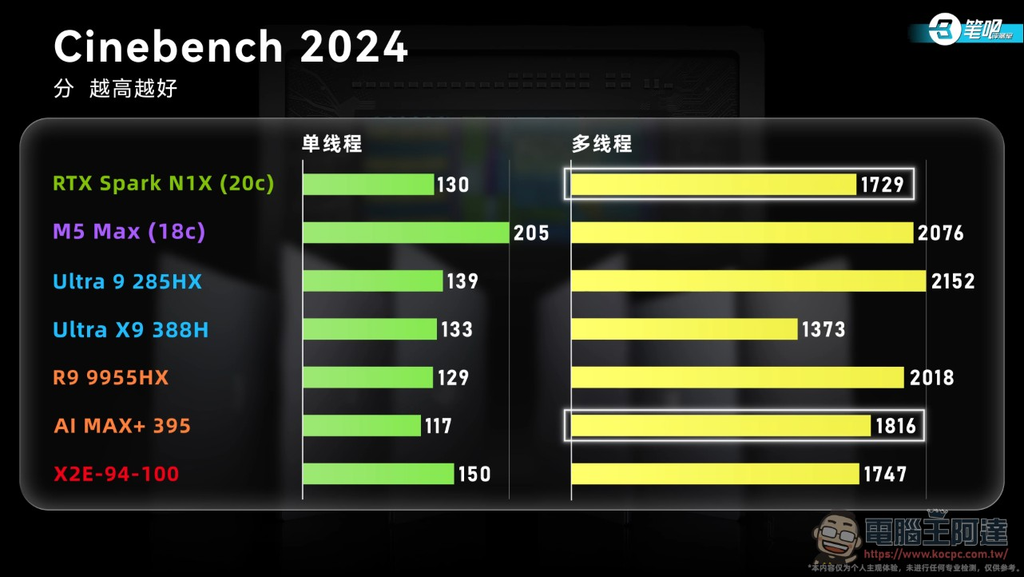
第一代 N1X 晶片將 CPU 與 GPU 分離為兩個獨立 Die,皆由台積電 3nm 製程打造。該晶片架構宛如小型伺服器 DGX Spark 所用 GB10 的 Windows 孿生版本,CPU 設計亦有 MediaTek 深度參與,主打高能源效率與連線擴展能力。N1X 在市場上提供兩種主要配置,標準版僅見於筆記型電腦:
| 配置項目 | 高階版 N1X | 標準版 N1X |
|---|---|---|
| CPU 核心規格 | 20 核心(10 顆 Cortex-X925 + 10 顆 Cortex-A725) | 18 核心(9 顆 Cortex-X925 + 9 顆 Cortex-A725) |
| GPU CUDA 核心數 | 6,144 | 5,120 |
| GPU 等效規模定位 | 介於筆電版 RTX 5070 Ti 至 RTX 5080 之間 | 介於筆電版 RTX 5070 至 RTX 5070 Ti 之間 |
| 統一記憶體容量 | 24GB 至 128GB | 24GB 至 32GB |
| SoC 散熱設計功耗(TDP) | 80W(CPU 與 GPU 共享) | 80W(CPU 與 GPU 共享) |
儘管運算規模龐大,但其硬體架構受到 80W 總功耗限制,且 L2 快取、記憶體頻寬與 ROPs 數量皆略低於傳統 RTX 50 系獨立顯示晶片,對純圖形渲染形成一定瓶頸。
聯想 YOGA Pro 15 RTX Spark 滿配版硬體與機構特點
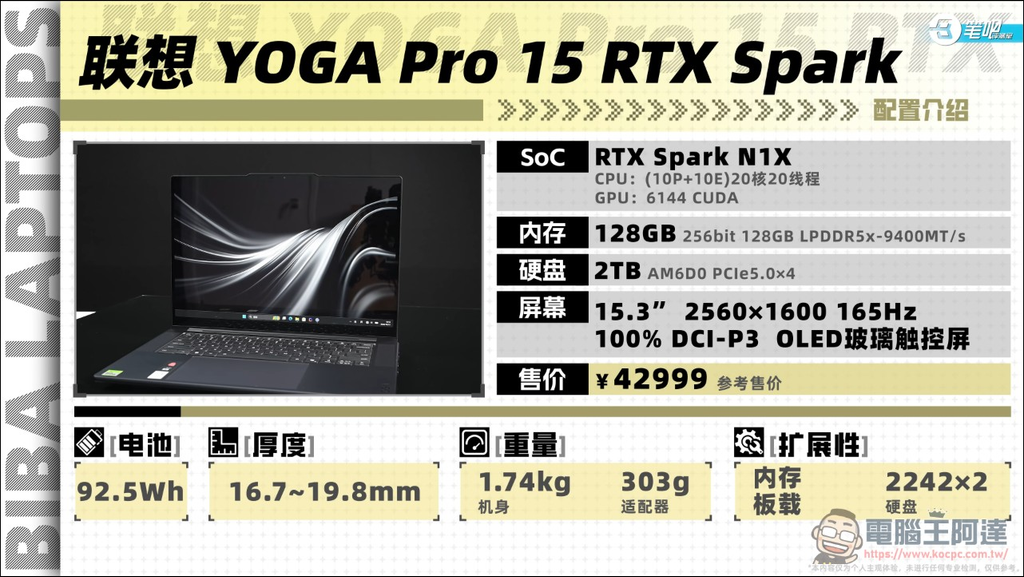
聯想 YOGA Pro 15 RTX Spark 頂規版本售價為 42,999 人民幣(折合約新台幣 20.8 萬元),硬體規格展現高水準用料:
- 核心平台:高階版 N1X 晶片(20 核心 CPU + 6,144 CUDA GPU)。
- 記憶體與儲存:256bit 128GB LPDDR5x-9400 統一記憶體,搭配 2TB 憶聯 AM6D0 PCIe 5.0 固態硬碟。
- 顯示螢幕:15.3 吋 2.5K(1600P)165Hz 廣色域 OLED 鏡面螢幕,無低頻 PWM 調光,但因缺乏 AR 塗層使深色場景反光較明顯。
- 輸入與配件:具備 1.5mm 鍵程韻律鍵盤,以及支援 4,096 級壓感、可作數位板使用的 7 吋全域按壓玻璃觸控板,隨機附贈數位筆。
- 外接介面:配置 2 組 USB4 Type-C、2 組 10Gbps USB-A、高速 HDMI 與高速 SD 讀卡機。
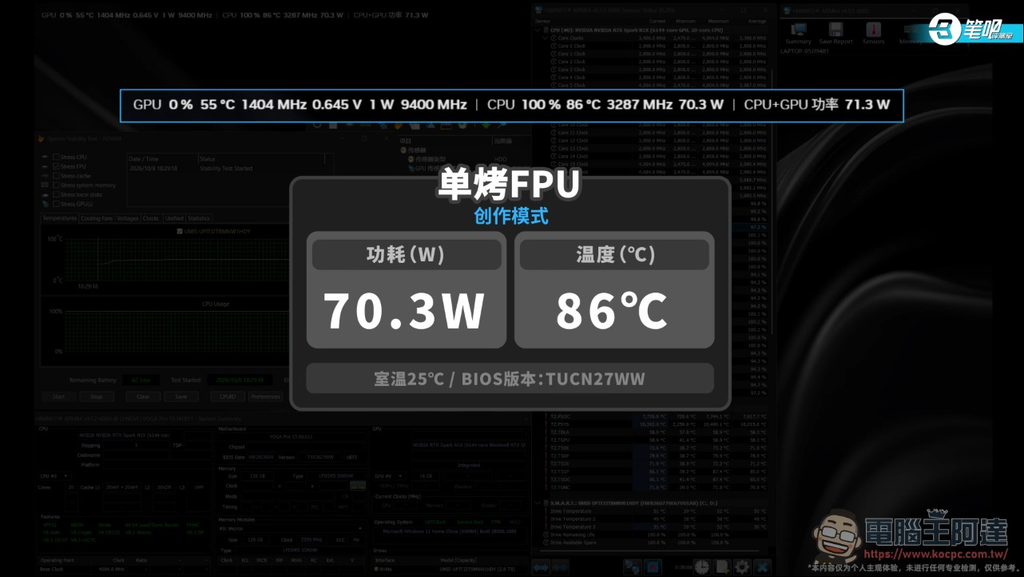
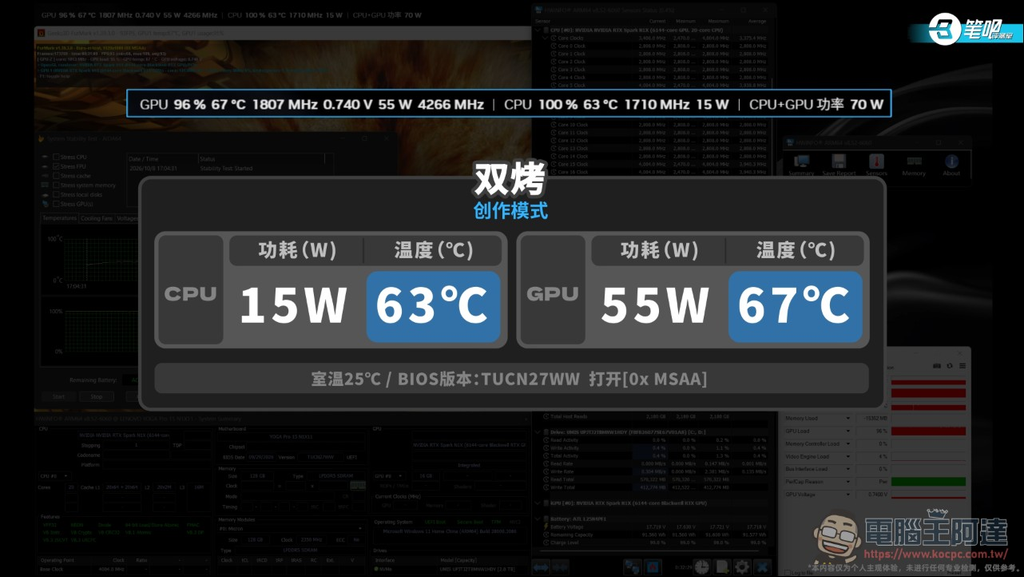
- 散熱與續航:採用 3 熱管雙風扇內吹模組,雙烤狀態下 CPU 分配 15W、GPU 分配 55W,溫度分別壓制在 63°C 與 67°C;內建 92.5Wh 電池,實測提供 8 小時 15 分鐘續航力。
GPU 與遊戲實測:轉譯損耗顯現生態陣痛
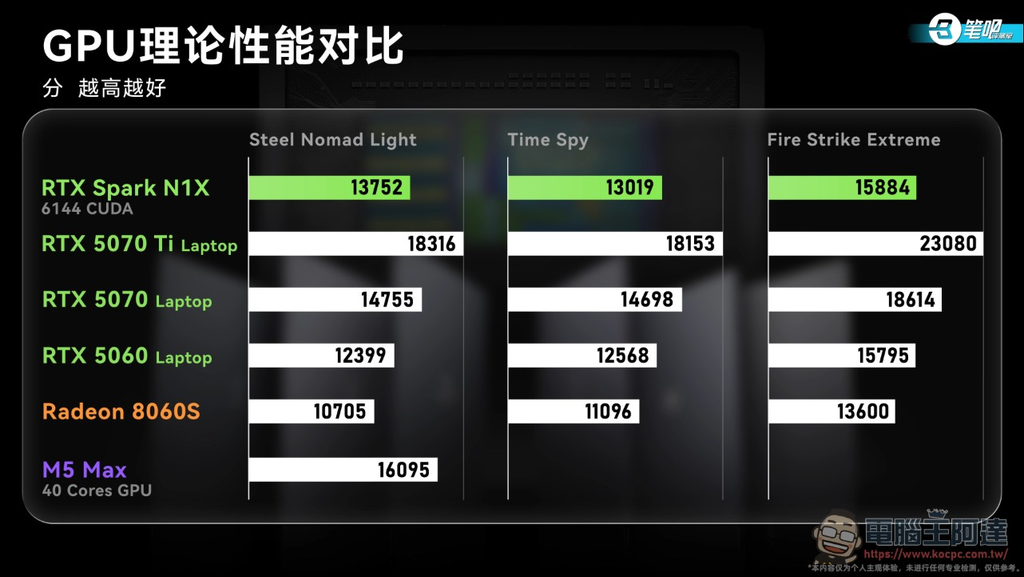
在圖形與遊戲測試中,ARM 架構與 x86 轉譯的差異明顯。3DMark Steel Nomad Light 原生測試中,N1X 跑出 13,752 分,表現優於 5060 但遜於 5070;而在需透過轉譯執行的 Time Spy 與 Fire Strike Extreme 中,綜合表現僅領先 RTX 5060 約 2%。
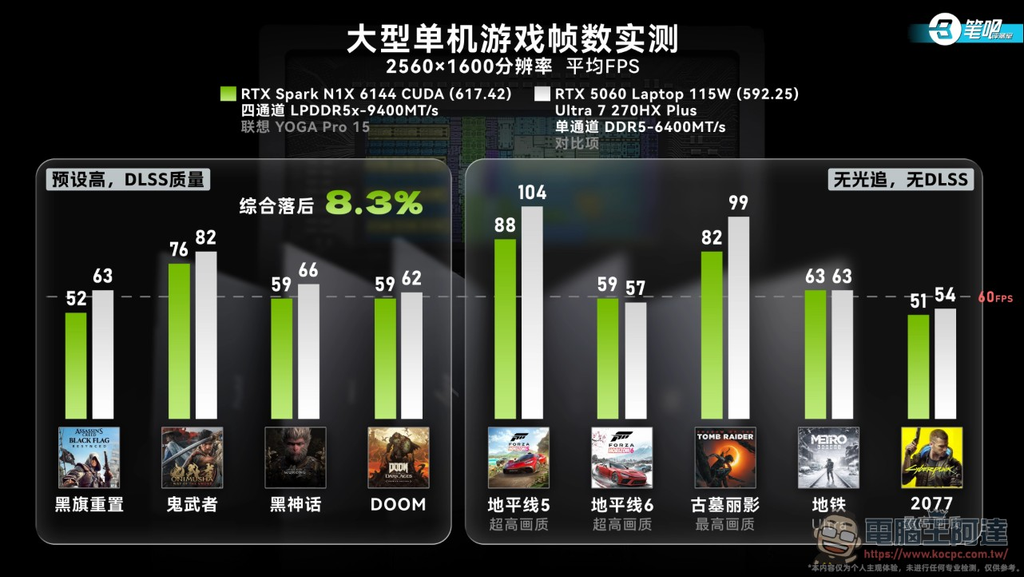
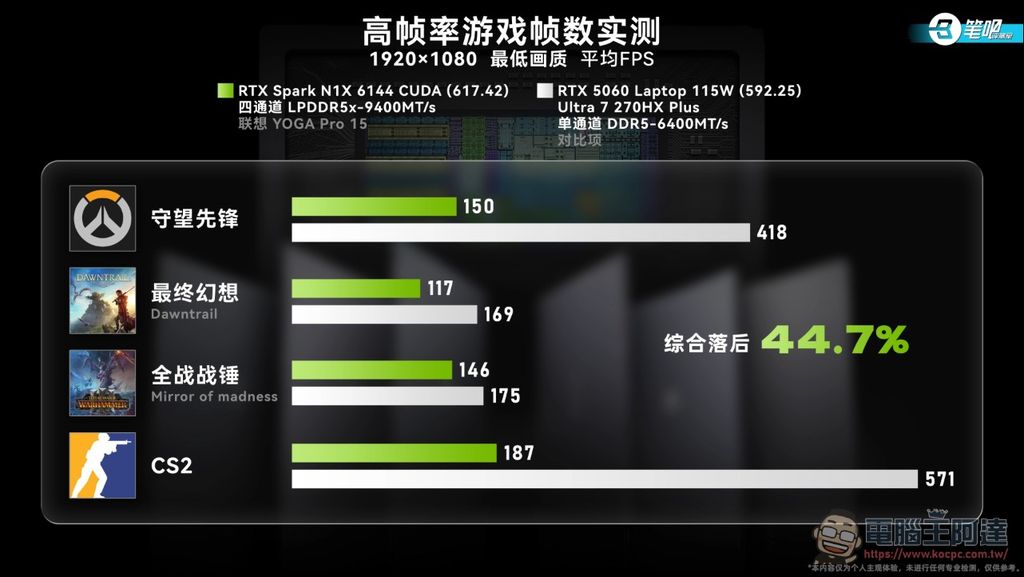
實際遊戲運行方面,單機遊戲平均幀數落後 RTX 5060 遊戲筆電 8.3%,吃重 CPU 的項目落後達 17.2%;競技與線上遊戲在 16 款實測中,有 5 款尚未支援(包括《英雄聯盟》、《三角洲行動》等),4 款可執行線上遊戲綜合落後 5060 機型 44.7%。不過,原生支援的 ARM64 版本《Minecraft》幀率可突破 1,000 幀,顯示轉譯損耗是主要效能落差來源,DLSS 與光線追蹤功能則運作穩定。
本地 AI 效能實測:高吞吐展現統一大記憶體優勢
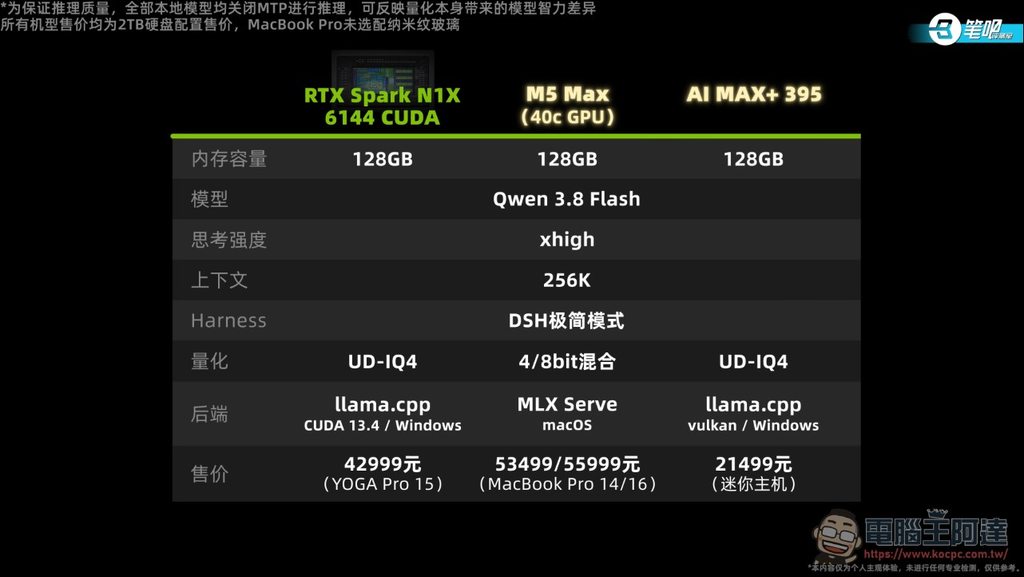
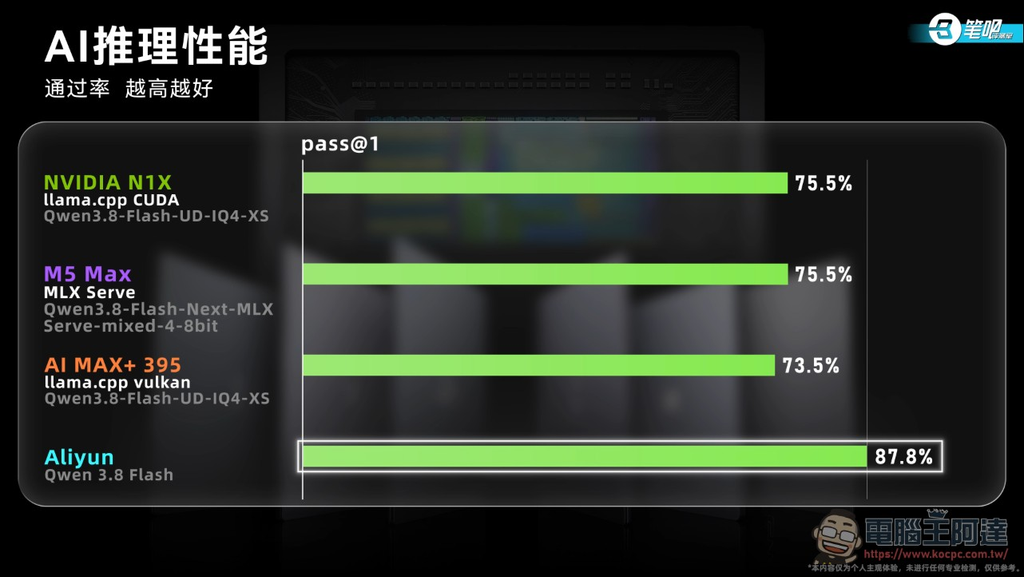
本地 AI 運算為 RTX Spark 的核心主場。在涵蓋軟體工程與資料科學等 49 個真實長程 Agent 任務評測中,搭載 128GB 記憶體的 RTX Spark 展現優異處理效率:
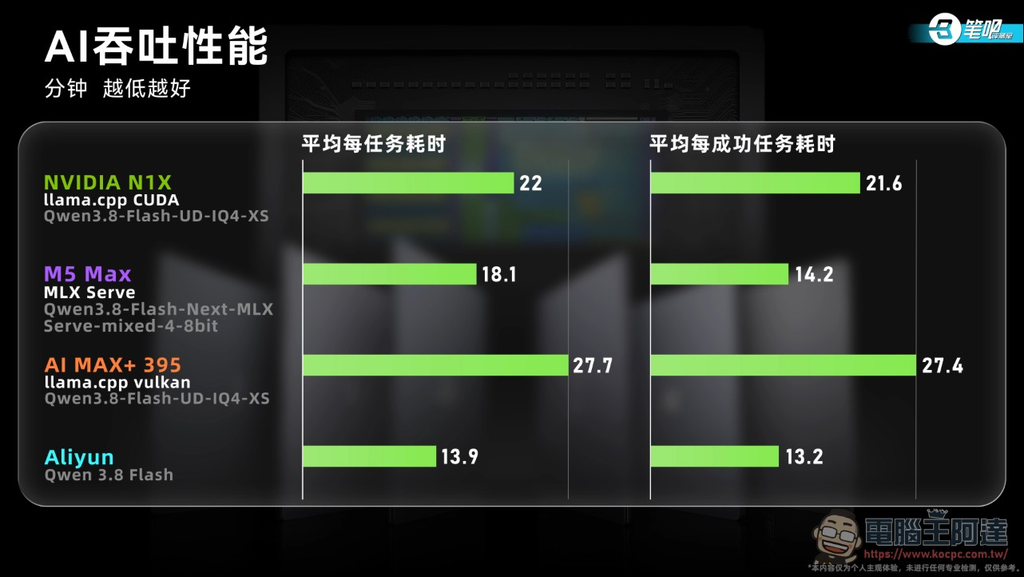
- 吞吐表現:平均預填充與解碼速度相較 AMD Ryzen AI MAX+ 395 分別快 22.2% 與 31.6%,平均任務耗時縮短 20.6%。
- 生態支援:llama.cpp 已獲得 NVIDIA 官方原生支援並可開箱即用,原廠宣稱其最高可於本地運作 120B 參數模型與百萬 Token 上下文。
- 模型表現:本地量化模型受限於長程穩定度與指令遵循能力,整體任務通過率依然不及雲端未量化的高階模型。
整體而言,聯想 YOGA Pro 15 RTX Spark 在機身工藝、散熱控制與大記憶體本地 AI 運算上展現卓越競爭力;但在 x86 軟體與大型遊戲原生生態全面普及之前,使用者仍須面對 Windows on ARM 現階段的轉譯成本。
Reference Link : kocpc.com.tw