

AI 摘要
- OpenAI 宣布推出七個月的極速程式碼模型正式退場。
- 開發者反映模型在多檔案及複雜任務中錯誤率過高難以投入生產。
- 新技術讓旗艦模型兼具極速推論,使縮減版極速模型失去存在價值。
OpenAI 程式碼模型(Codex)負責人蒂博(Tibo)日前在社群平台 X 上宣布,上線僅七個月的極速程式碼模型 GPT-5.3-Codex-Spark 將於下週正式退役。該模型於今年 2 月推出,曾以每秒輸出超過 1,000 個 Token 的高吞吐量著稱,並作為 OpenAI 擺脫對 NVIDIA 硬體單一依賴的首款生產級模型,然而最終因使用量持續下滑而結束服務。
極速生成背後的精確度瓶頸
在 GPT-5.3-Codex-Spark 推出初期,其主打即時編程體驗,顯著降低首字延遲(Time-to-First-Token),讓程式碼生成速度呈現如瀑布般的輸出。然而,隨著開發者社群在實際工程情境中深度使用,負面反饋逐漸浮現。
許多一線軟體工程師指出,當任務涉及多檔案上下文理解或複雜日誌分析時,GPT-5.3-Codex-Spark 容易迅速耗盡脈絡限制,並出現捏造不存在的 API 端點或產出結構損壞的 JSON 等問題。程式碼培訓機構涂林學院(Turing College)對此分析表示:「沒有智慧的速度,只是更快地製造失敗。」對工程團隊而言,等待能通過測試的正確解法,成本遠低於修正大量錯誤程式碼。
基準測試揭露效能落差
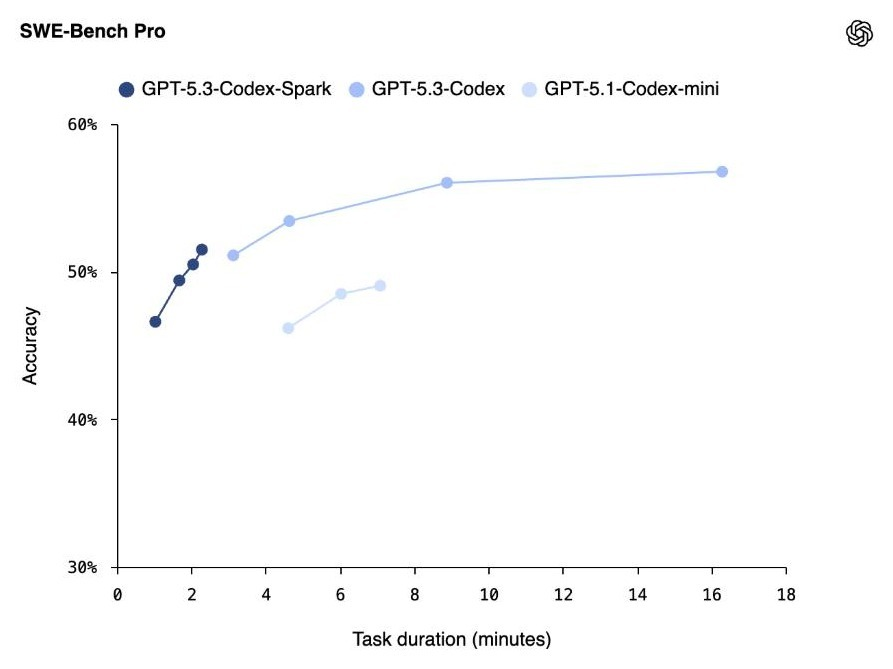
實測數據進一步挑戰了官方宣傳的效能數據。開發者 Nicholas Van Landschoot 實測發現,官方所稱的「15 倍效能提升」是以 Spark 對比最高推論強度的完整旗艦模型;若在相同準確率基準下對比,其實際加速幅度約為 1.37 倍。
在客觀基準測試方面,GPT-5.3-Codex-Spark 在各項程式碼評測中表現受限:
- Terminal-Bench 2.0:準確率維持在 50% 上下。
- SWE-Bench Pro:同樣僅達約 50% 水準,顯著低於標準版 GPT-5.3-Codex。
這導致該模型逐漸失去主力開發工具的地位,多數使用者僅在其提供額外獨立配額時,作為備用資源短暫使用。
硬體架構突破:旗艦模型直接支援極速模式
GPT-5.3-Codex-Spark 最初採用蒸餾架構的小模型設計,主因是單一晶圓無法容納未縮減的完整旗艦模型。然而,Cerebras 於 8 月推出的「Ultrafast 模式」改變了此局限。
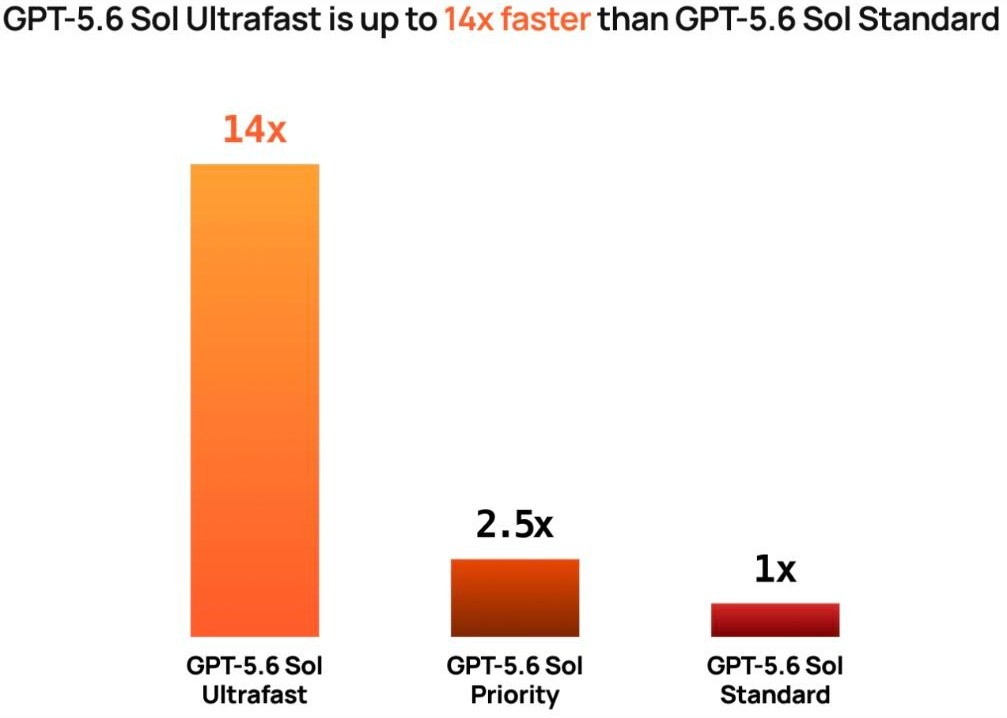
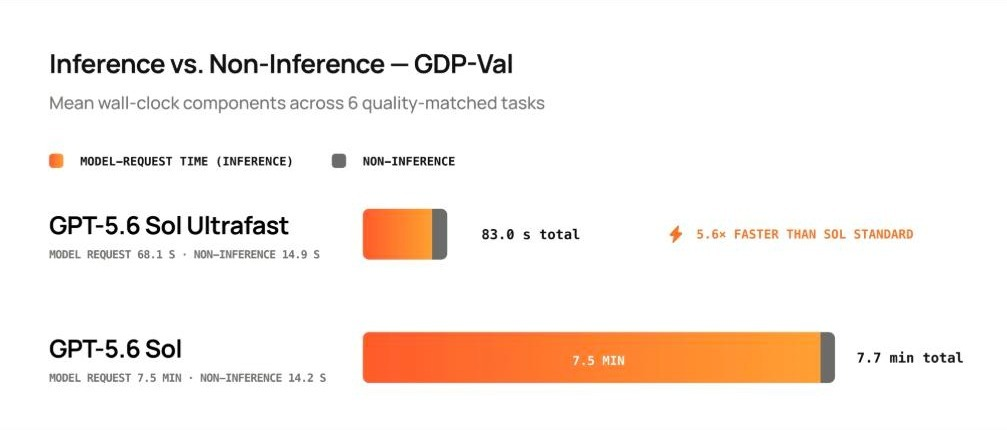
Cerebras 透過跨 CS-3 節點的多層流水線切分技術,將未經蒸餾的旗艦模型 GPT-5.6 Sol 部署於晶圓級晶片上。該技術在維持旗艦級推理解題水準的同時,達成了每秒 750 個 Token 的輸出速率,較標準模式提升 14 倍。在 GDP-Val 測試中,標準版 Sol 需耗時 7.7 分鐘的複雜任務,切換至 Ultrafast 模式後縮短至 83 秒,端到端執行速度加快 5.6 倍,證明旗艦模型與極速推論已可並存。
OpenAI 產品命名與服務架構整頓
GPT-5.3-Codex-Spark 的退役亦反映 OpenAI 近期的產品線重組策略。從 6 月初淘汰 GPT-5.2 與初代 5.3-Codex、8 月底將 5.4 世代退役並轉移至 5.6 系列,到 9 月正式移除 Spark,OpenAI 正清理過往帶有複雜版號及後綴的命名方式,全面轉向 Sol、Terra、Luna 及 Astra 等自然天體命名系統。
在架構調整後,推論速度不再作為獨立模型發佈,而是轉化為旗艦模型內部的性能檔位(如 Standard、Priority 及 Ultrafast)。作為 OpenAI 與 Cerebras 簽署 750 兆瓦合約後的先導實踐,GPT-5.3-Codex-Spark 驗證了大規模生產流量在非 CUDA 生態系上運行的可行性,並在完成特定階段任務後完成退場。
Reference Link : techbang.com