

AI 摘要
- 開源專案讓 AMD 顯卡在 Windows 下免改代碼執行 CUDA。
- 實測 RX 9060 XT 成功跑通 220 萬參數強化學習模型訓練。
- 目前 Windows 環境仍缺乏 cuDNN 支援,深度學習主流應用受限。
開源社群近日迎來重大技術突破,獨立開發者 Speedstu 在 GitHub 正式釋出名為 CUDA-for-AMD-Windows 的開源專案。這套專案透過高度整合的自動化腳本與中介轉譯技術,讓 AMD Radeon 顯示卡使用者得以在 Windows 作業系統中直接呼叫 CUDA 加速函式庫,完全無需修改底層程式碼即可順利運作深度學習運算,為長期受限於 NVIDIA 獨佔生態的個人開發者提供全新硬體相容方案。
中介轉譯架構:ZLUDA 結合 AMD HIP 驅動映射
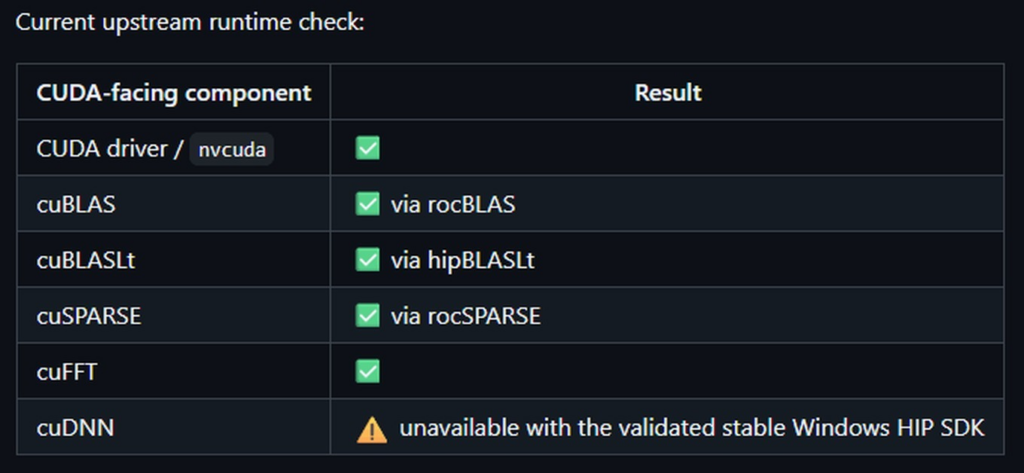
CUDA-for-AMD-Windows 的核心技術在於運用 PowerShell 自動化配置,將開源轉譯層 ZLUDA(v6-preview.69)與 AMD 原生 HIP / ROCm 架構相結合。當應用程式送出 CUDA 運算呼叫時,系統會在驅動層進行動態攔截,將原生的 nvcuda 相關請求直接映射至 AMD 本地安裝的數學加速庫。
目前該工具已實作多個核心數學庫的無縫映射:
- 矩陣運算:cuBLAS 與 cuBLASLt 自動轉發至 AMD rocBLAS 及 hipBLASLt。
- 稀疏矩陣與變換:cuSPARSE 與 cuFFT 分別對應至 rocSPARSE 與相關運算模組。
實機效能驗證:AMD Radeon RX 9060 XT 實測數據
在具體實測中,開發團隊採用 AMD Radeon RX 9060 XT 顯示卡執行 220 萬參數的 PPO(近端策略最佳化,Proximal Policy Optimization)強化學習神經網路訓練,驗證其端到端運算能力。測試對比了「公開上游路徑」(官方 ZLUDA 搭配 AMD HIP SDK 6.4)與「自訂修訂路徑」(混用舊版客製化組件)的效能表現:
| 配置路徑 | 中位數輸送量 (SPS) | 平均輸送量 (SPS) | 運算延遲表現 |
|---|---|---|---|
| 公開上游路徑 (官方 ZLUDA + HIP SDK 6.4) | 13,278.46 | 13,172.49 | 推論與訓練表現穩定高效 |
| 自訂修訂路徑 (含舊版客製化組件) | 12,875.80 | 較低 | 推論與學習耗時明顯拉長 |
現階段技術限制與生態挑戰
儘管 CUDA-for-AMD-Windows 成功證明了跨架構相容的可行性,但目前在應用場景上仍有明顯局限。核心深度學習加速庫 cuDNN 在 Windows 平台的 AMD HIP SDK 中依然處於無法支援(unavailable)狀態,代表依賴卷積與深度特徵提取的主流電腦視覺(CV)和大型語言模型(LLM)尚無法直接套用。此外,NVIDIA 使用者授權合約對 API 轉譯的限制,以及非官方支援的穩定性,皆是此工具邁向日常主力開發仍需面對的課題。
Reference Link : techbang.com