

AI 摘要
- 微軟宣布 GitHub Copilot 將於本月底前正式支援裝置端本機模型推理。
- 同步發表具備 1,370 億總參數的 MAI Code 1.1 Flash 混合專家模型。
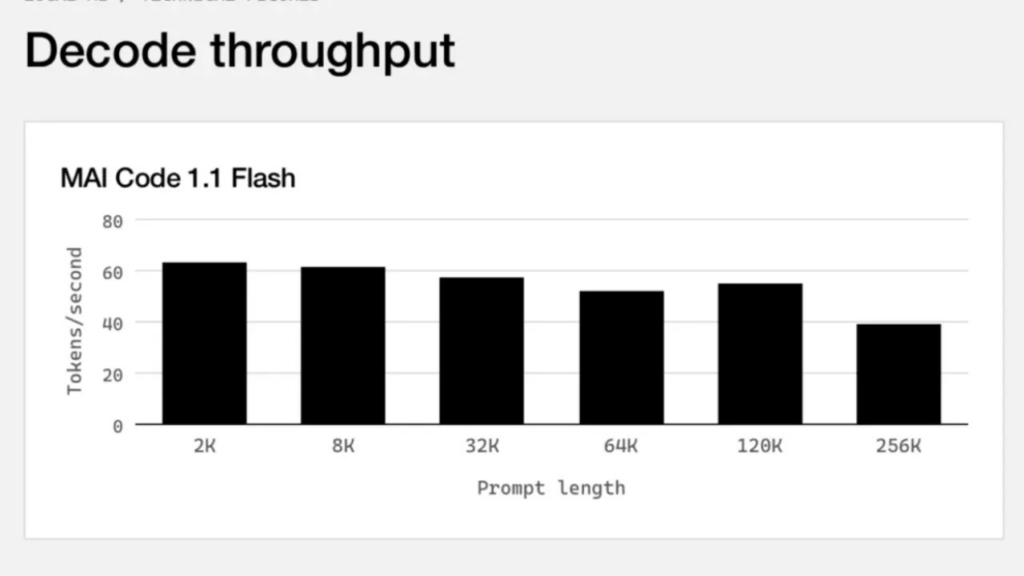
- 實測於 Surface Laptop Ultra 上解碼吞吐量最高可達每秒 63 個 Token。
微軟正式宣布旗下 AI 程式碼輔助工具 GitHub Copilot 將於本月底前支援本機人工智慧模型推理。這項重大更新讓開發者能夠在雲端與裝置端模型之間進行自動或手動切換,大幅降低對網絡連線的依賴,並同步帶來更低延遲的開發環境。
全新協調機制:雲端與裝置端自由切換
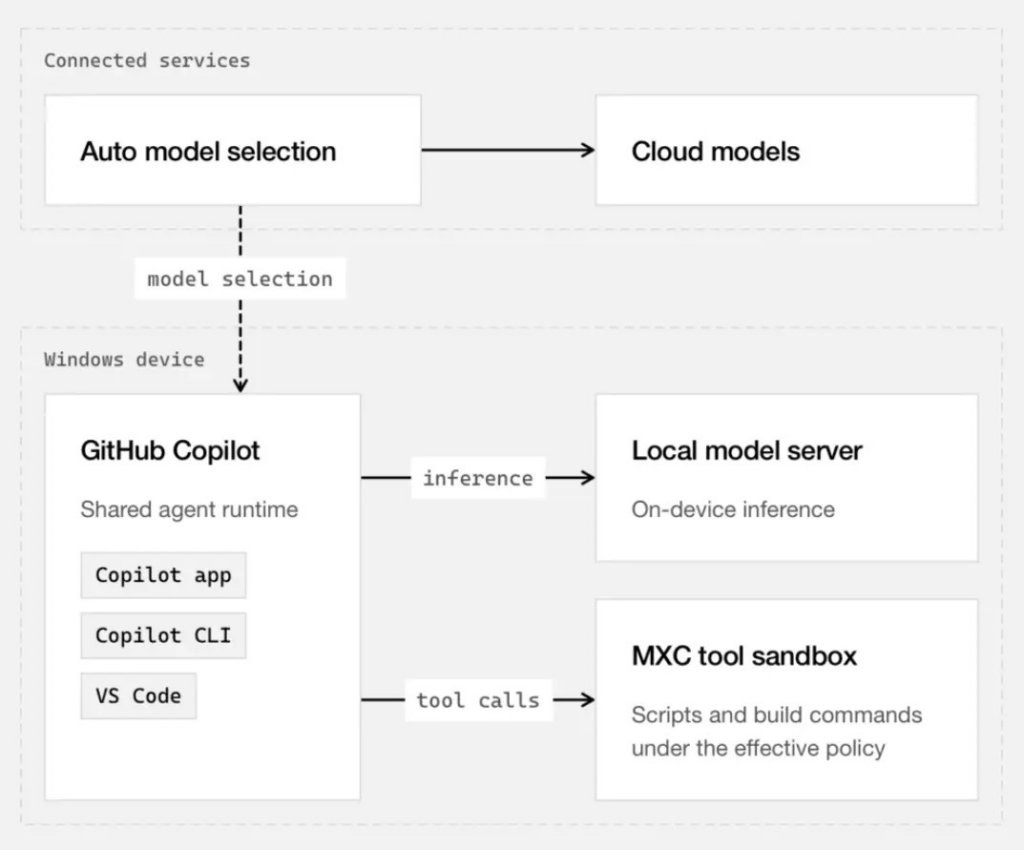
GitHub Copilot 目前主要依賴雲端託管模型運作,透過協調器(Orchestrator)根據效能、成本與準確性來路由每一次的程式碼請求。在本月底更新後,該路由機制將正式下沉至裝置端。開發者可在 Visual Studio Code、Copilot 應用程式以及 Copilot CLI 中自由選擇偏好:
- 自動編排:系統將自動評估任務複雜度,在雲端或本機端模型間動態調度。
- 強制本機模式:完全限定使用裝置端模型,滿足離線開發與高度隱私需求。
開發者能透過 Windows ML 呼叫原廠模型,亦可直接連接與 OpenAI 相容的本機端點,靈活調用客製化的本機 AI 模型。
專屬裝置端架構:MAI Code 1.1 Flash 混合專家模型
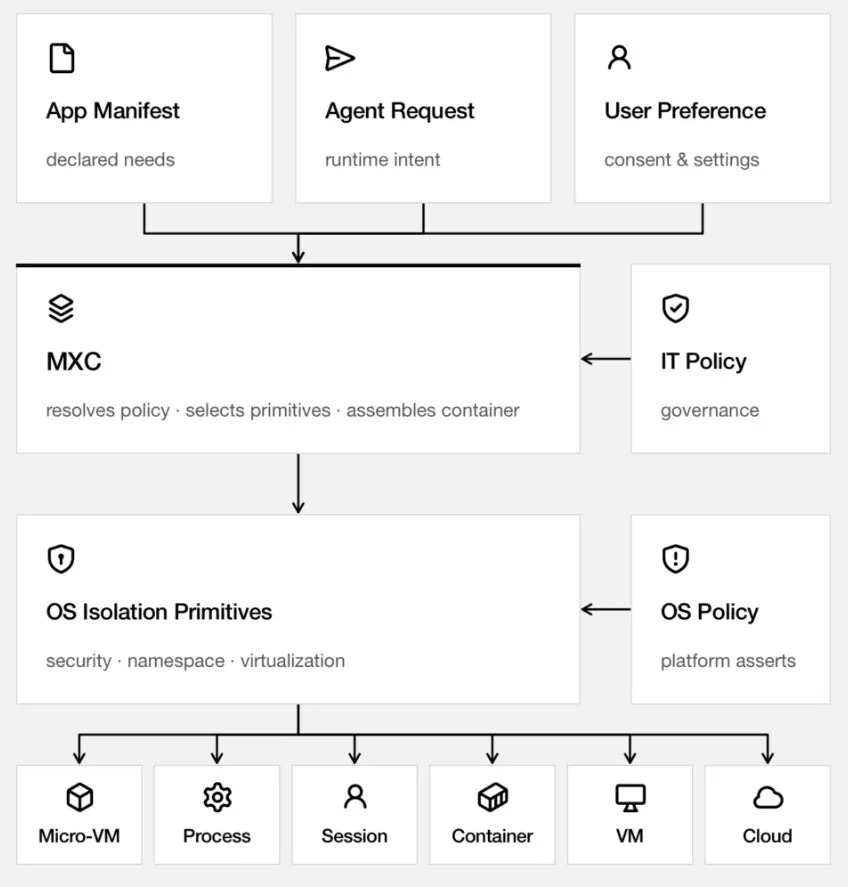
微軟同步發表了專為本機推理打造的「MAI Code 1.1 Flash」模型。該模型採用混合專家(MoE)架構,並透過量化技術與推測解碼(Speculative Decoding)大幅壓縮記憶體佔用與回應延遲,在維持千億級參數實力的同時,單次運算僅需動用部分參數。
| 規格項目 | MAI Code 1.1 Flash 技術指標 |
|---|---|
| 模型架構 | Mixture of Experts(MoE)混合專家模型 |
| 總參數規模 | 1,370 億(137B) |
| 單次活躍參數 | 68 億(6.8B) |
| 加速技術 | 量化技術、推測解碼(Speculative Decoding) |
| 實測解碼吞吐量 | 每秒 40 至 63 個 Token(提示長度 2K 至 256K) |
| 測試硬體平台 | Surface Laptop Ultra |
硬體實測表現與推出時程
在 Surface Laptop Ultra 上的實際測試顯示,處理複雜程式設計任務時,峰值記憶體使用率與處理速度均有顯著改善。在 2K 至 256K Token 的提示長度測試範圍內,解碼吞吐量穩定維持在每秒 40 到 63 個 Token 之間。
本機推理功能預計於本月底前陸續開放給開發者體驗,更多支援的模型範圍與細節預計將於微軟官方後續更新中公布。
Reference Link : techbang.com