

AI 摘要
- Google 發表第八代 TPU 新系統 TPU 8tx 與 TPU 8i Max,今年首度達到一年推出四款 TPU 系統。
- Google TPU 8tx 以 TPU 8t 晶片為基礎加入硬體層機密運算,CPU 經 PCIe 到晶片的傳輸全程加密,並可部署於特定企業地端資料中心。
- TPU 8i Max 將兩顆 8i 晶片封裝於單一模組,系統層級記憶體達 384GB、頻寬每秒 17.2TB,皆較 8i 提升。
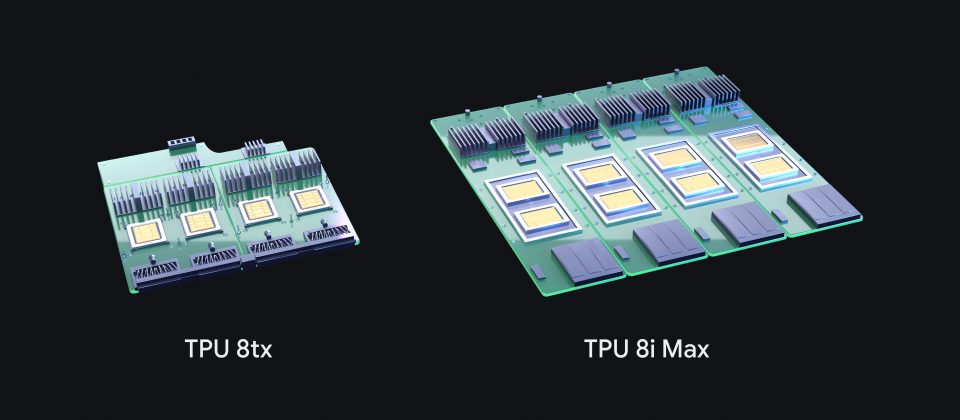
Google 再度加快 TPU 的產品節奏。繼今年 4 月於 Next 大會發表第八代 TPU 晶片 TPU 8t 與 TPU 8i 之後,Google 今日再推出兩款以相同晶片為基礎的新系統:主打硬體層機密運算的 Google TPU 8tx,以及因應百萬級 Token 上下文需求的 TPU 8i Max。這也是 Google 首度在一年內推出四款 TPU 系統,官方將此定位為搶攻企業 AI 規模化需求的关键一步。
Google Cloud AI 與運算基礎架構副總裁暨總經理 Mark Lohmeyer 在線上媒體說明會中指出,TPU 的迭代速度已從過去每兩年一款新系統,加快到每年一至兩款,今年更進入一年四款的階段。他並強調「晶片」與「系統」的不同:晶片指的是一款全新設計的晶片,系統則是把運算、網路、儲存等最佳化設計與晶片整合而成的新解決方案。
代理時代的三個根本轉變
Mark Lohmeyer 認為,AI 代理時代帶來三項根本性轉變,是 Google 必須加速推出系統級產品的原因:
- 從人類規模走向代理規模(Agent Scale):單一使用者就可能帶來百倍甚至千倍的平行處理需求。
- 從記錄性系統走向行動性系統(Systems of Action):AI 不再只做檢索與摘要,還要與業務系統、資料系統互動,甚至代表使用者執行任務,因而帶來新的安全性與合規性挑戰。
- 從簡單請求走向複雜代理工作流程:AI 系統經常需要存取龐大上下文資料,並在長時間的多步驟流程中維持這些資訊。
他表示,這些轉變讓基礎設施的挑戰不再只取決於擁有多少 GPU 或 TPU,還包括資料移動速度、記憶體使用效率、延遲與成本,以及高度安全性與合規要求。這也意味著 AI 供應商的競爭,從單純的 AI 算力競賽,跨入同時考量運算、網路、儲存與安全的系統級效能競爭。
Google TPU 8tx:把加密延伸至 PCIe 傳輸路徑
第一款新系統 Google TPU 8tx 以第八代 TPU 8t 晶片為基礎,在硬體層增加安全機制,並搭配客製化 AMD CPU 的主機提供機密運算能力,確保資料傳輸與處理的每一個環節都經過加密。
具體而言,資料從 CPU 經由 PCIe 傳輸至 TPU 8tx 晶片的整條路徑都受到加密保護,可避免模型權重、提示詞與企業資料外洩,也避免遭到系統操作人員窺探。這項能力不只適用於模型訓練,用於推論時同樣能加密敏感資料與模型權重。
部署彈性則是另一項重點:TPU 8tx 的機密運算能力除了可部署在 Google 公雲,Google 也開放特定企業將系統部署於自有地端資料中心,降低實體環境操作人員接觸敏感資料的風險。此外,TPU 8tx 也把原本屬於 TPU 8i 的低延遲網路拓樸架構 Butterfly 引進系統中,縮短晶片之間的通訊路徑,使其在提供硬體層級機密推論保護的同時,還能進一步降低推論延遲。
在客群設定上,TPU 8tx 瞄準需要最高等級機密運算的企業,例如受到高度監管的產業、需要高度合規性的產業,或是希望在各種環境中加密保護模型權重的模型供應商。
TPU 8i Max:把高速公路的車道加寬
第二款新系統 TPU 8i Max 將兩顆 8i 晶片整合封裝於單一模組,在系統層級提供 384GB 高頻寬記憶體,比 8i 多了 33%,用以支援更多上下文資料與 KV 快取。其記憶體存取頻寬也翻倍至每秒 17.2TB,加快資料傳輸速度;晶片上的 SRAM 快取記憶體同樣翻倍增加到 768MB。
Mark Lohmeyer 以高速公路比喻 TPU 8i Max 的設計思路:重點不是讓每一輛車開得更快,而是在高速公路上增加更多車道,讓更多車輛通過,達到 2 倍的吞吐率。他說,當大量代理同時有檢索與生成輸出的需求時,整體吞吐量的提升對維持回應速度極為重要,這也正是 TPU 8i Max 瞄準大規模 AI 代理需求的理由。
應對場景上,TPU 8i Max 針對需要處理大量上下文、檢視大量檔案、文件與電子郵件,並由大量 AI 代理同時執行任務、且必須維持高吞吐量與效能的應用。
兩款新系統規格對照
| 比較項目 | Google TPU 8tx | TPU 8i Max |
|---|---|---|
| 基礎晶片 | 第八代 TPU 8t | 第八代 TPU 8i(雙晶片封裝於單一模組) |
| 核心訴求 | 硬體層機密運算 | 大上下文、高吞吐推論 |
| 安全機制 | CPU 經 PCIe 至晶片的傳輸路徑全程加密 | 來源未說明 |
| 記憶體 | 來源未公布 | 系統層級 384GB 高頻寬記憶體,較 8i 增加 33% |
| 記憶體頻寬 | 來源未公布 | 每秒 17.2TB,較 8i 翻倍 |
| SRAM 快取 | 來源未公布 | 768MB,較 8i 翻倍 |
| 網路架構 | 導入 8i 的 Butterfly 低延遲拓樸 | Butterfly 低延遲拓樸 |
| 部署方式 | Google 公雲,或特定企業地端資料中心 | 來源未說明 |
| 目標客群 | 高度監管、高度合規產業與模型供應商 | 大量代理同時執行任務、需處理大量文件與上下文的應用 |
降低門檻:TorchTPU 與開源推論引擎後端
除了硬體,Google 也同步處理軟體生態的門檻問題。Google 的目標是讓 TPU 變得像通用硬體一樣容易使用。上個月在 PyTorch 大會上,Google 發表了與 Meta 合作發展的 TorchTPU 開源專案,這是專為 TPU 打造的原生 PyTorch 後端,可讓 PyTorch 開發者保留模型、程式碼、函式庫、工具與所有工作流程。
Mark Lohmeyer 表示,只要修改幾行設定程式碼,就能從 GPU 轉換至 TPU 執行。他指出 PyTorch 是企業最愛用的 AI 框架,推出 TorchTPU 是 Google 擴大 TPU 採用率與吸引力的整體策略之一。Google 同時也為開源推論引擎 vLLM 與 SGLang 推出搭配的 TPU 後端,讓這兩大引擎不只支援 GPU,現在也開始能支援 TPU。TPU 過去主要透過 JAX 工具與 TensorFlow 框架搭配使用,TorchTPU 專案則開始對 PyTorch 提供原生支援。
售價與上市時程尚未公布
值得注意的是,Google 此次說明會聚焦產品定位、架構設計與目標客群,並未公布 Google TPU 8tx 與 TPU 8i Max 的售價、具體開放使用的時間表或一般供應時程。可確認的是,TPU 8tx 將提供公雲與特定企業地端兩種部署途徑,而 TPU 8i Max 則以系統層級的記憶體與頻寬倍增作為主要賣點。
Mark Lohmeyer 也預告,硬體基礎設施與軟體系統正針對特定的工作負載與使用案例進行更高度的專業化分工,未來會看到更多類似發展,Google 也會加速產品與功能開發來因應這些多樣化需求。
Reference Link : ithome.com.tw