

AI 摘要
- Mac Studio M5 Ultra 在 125B MoE 本地模型生成速度達 114 tok/s,較前代大幅提升約 66%。
- StreamBench 實測記憶體頻寬達 1,035.82GB/s,首字反應時間縮短逾六成。
- GPU 在 AI 推理負載下的估算功耗僅增加約 6%,能效表現顯著改善。
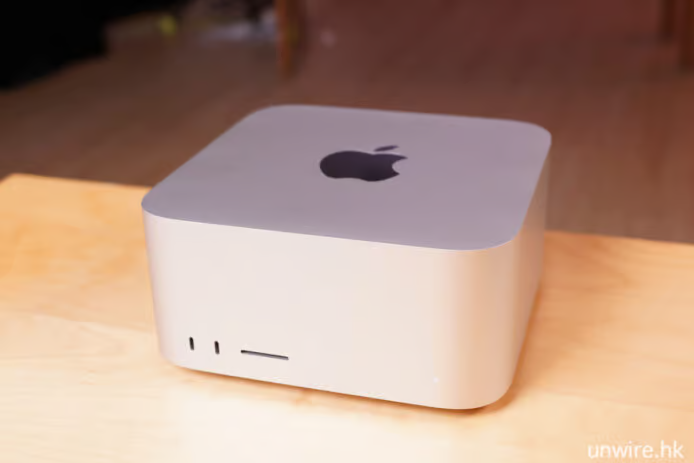
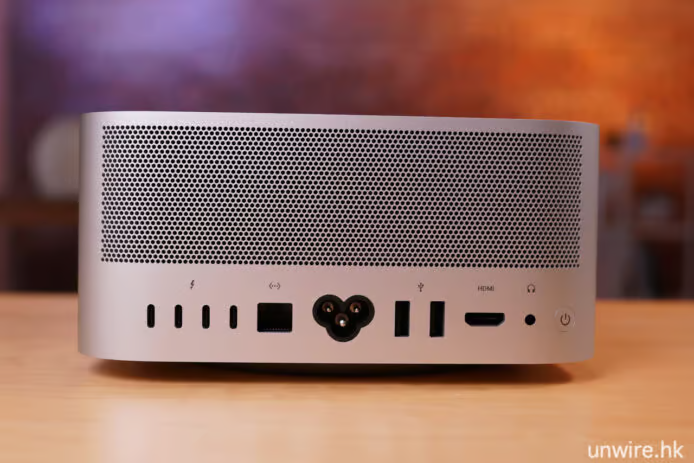
Apple 最新桌面工作站 Mac Studio M5 Ultra 正式登場。作為面向專業開發者與創作者的高階機種,該設備將官方規格的記憶體頻寬推升至 1.2TB/s,並在 GPU 架構中為每個核心加入神經網絡加速器(Neural Accelerator),同時搭載全新著色器核心(Shader Core)、第二代動態快取(Dynamic Caching)與新版 UltraFusion 晶片封裝架構。對於需要高度依賴大容量統一記憶體(Unified Memory)執行本地大型語言模型(Local LLM)的專業用戶而言,其實戰效能躍升成為關注焦點。
測試環境與機型規格對比
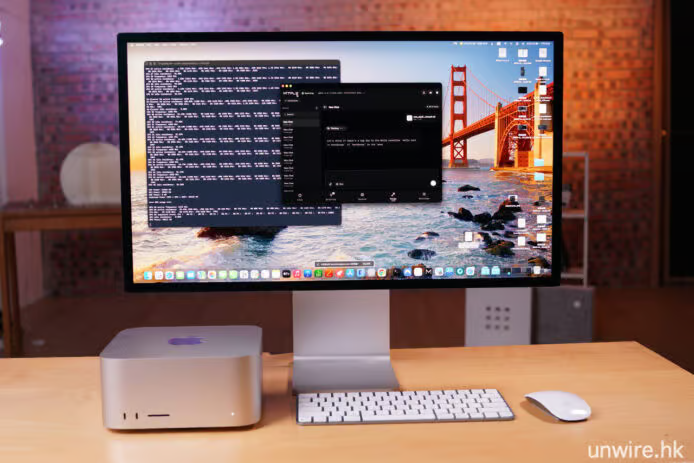
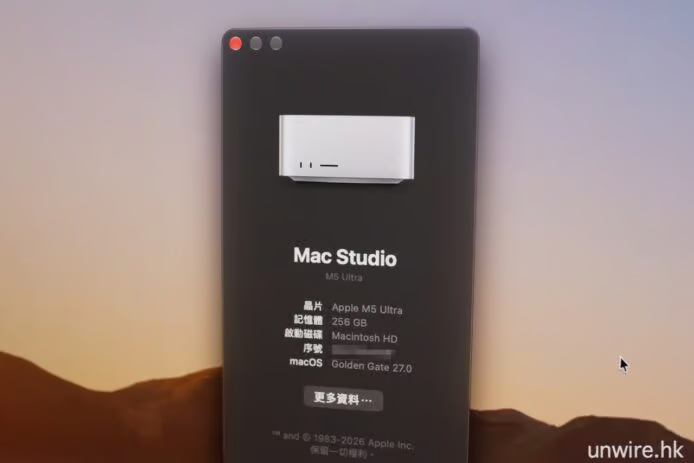
本次實測採用頂規配置的 Mac Studio M5 Ultra(配備 30 核心 CPU、64 核心 GPU、256GB 統一記憶體及 4TB SSD),並與相同記憶體與儲存容量規格的上一代 Mac Studio M3 Ultra 進行基準對比。
測試環境採用 MTPLX 平台,挑選兩款不同架構的開源模型進行深度驗證:一為 27B 密集型模型 Qwen 3.8 27B Optimized Quality(動態 8-bit,實測記憶體佔用約 33.7GB 至 36.1GB);另一為具備 125B 主參數的混合專家模型 Qwen 3.8 Flash-Next Optimized Speed(Dynamic 4-bit, Sparse Attention 8-bit,實測記憶體佔用約 109.4GB 至 109.6GB)。為避免傳統純文字生成的局限,測試題目採用改編自 LeetCode Hard 的 Python 除錯情境,驗證模型在短上下文內的邏輯修正效能。
本地大型語言模型推理速度顯著提升
實測數據顯示,在運行 Qwen 3.8 27B 時,M5 Ultra 的生成速度達到 80.3 tok/s,較 M3 Ultra 的 56.4 tok/s 提升約 42.4%;代表首字反應時間的 TTFT(Time To First Token)從 1.50 秒銳減至 0.54 秒。
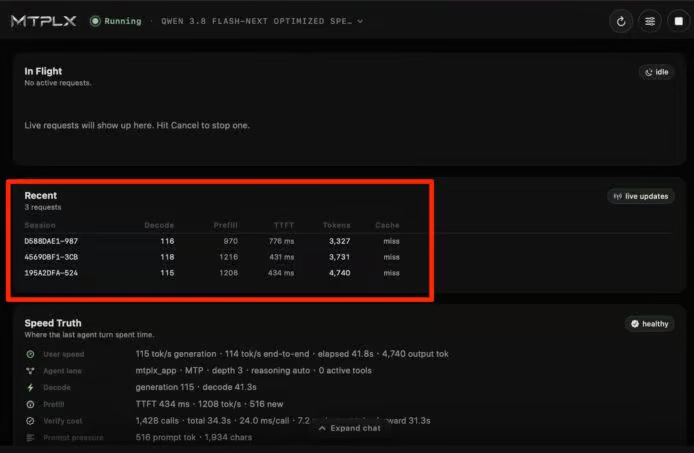
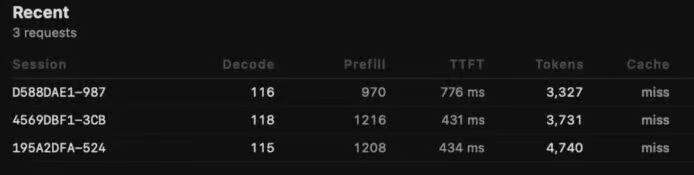
在負載更高的 125B 級別 Qwen 3.8 Flash-Next 測試中,兩代效能差距進一步拉開。M5 Ultra 達到 114 tok/s 的生成速度,相比 M3 Ultra 的 69.4 tok/s 增長達 65.7%,TTFT 亦由 1.10 秒縮短至 0.43 秒。此外,在讀入提示詞的 Prefill 階段,27B 模型在 M5 Ultra 上錄得 1,095 tok/s(約前代 2.9 倍),Flash-Next 則達到 1,208 tok/s(約前代 2.15 倍)。
| 模型名稱 | M3 Ultra 生成速度 | M5 Ultra 生成速度 | 增長幅度 | TTFT 縮短幅度 |
|---|---|---|---|---|
| Qwen 3.8 27B | 56.4 tok/s | 80.3 tok/s | +42.4% | 約 64% |
| Qwen 3.8 Flash-Next (125B) | 69.4 tok/s | 114 tok/s | +65.7% | 約 61% |
記憶體頻寬與功耗表現分析
本地 LLM 推理高度依賴記憶體讀寫通道。透過 StreamBench GPU Triad 實際測試,M5 Ultra 的實測頻寬達 1,035.82GB/s,相較 M3 Ultra 的 688.47GB/s 增加約 50.5%,與官方宣稱的 1.2TB/s 規格走勢一致。除頻寬提升外,新架構的運算單元優化亦共同促成了大型 MoE 模型的顯著加速。
功耗方面,利用 macOS 內建 Powermetrics 進行軟體估算,運行 27B 負載時 M5 Ultra 的 GPU 平均功耗約 67.7W(前代約 63.9W);Flash-Next 負載時約 48.0W(前代約 45.2W)。兩者平均功耗僅增長約 6%,對應生成效能提升逾四成至六成,展現出較佳的能耗轉換比。
| 工作負載 | M3 Ultra GPU 功耗估算 | M5 Ultra GPU 功耗估算 | 功耗增幅 | 生成速度增幅 |
|---|---|---|---|---|
| Qwen 3.8 27B | 約 63.9W | 約 67.7W | 約 +5.9% | +42.4% |
| Qwen 3.8 Flash-Next | 約 45.2W | 約 48.0W | 約 +6.0% | +65.7% |
傳統運算基準與 I/O 表現
在標準基準測試中,M5 Ultra 同樣維持全面成長:
- Geekbench 7:CPU 單核心分數達 3,758(提升 30.3%),多核心分數達 52,464(提升 37.6%),Metal 圖形分數達 355,158(提升 40.8%)。
- Cinebench 2026:CPU 多核心分數達 17,774(提升 59.0%),GPU 分數達 140,943(提升 72.2%)。
- Blackmagic Disk Speed Test:4TB 配置下,寫入速度達 11.35GB/s(提升 61%),讀取速度達 13.76GB/s(提升約 139%)。
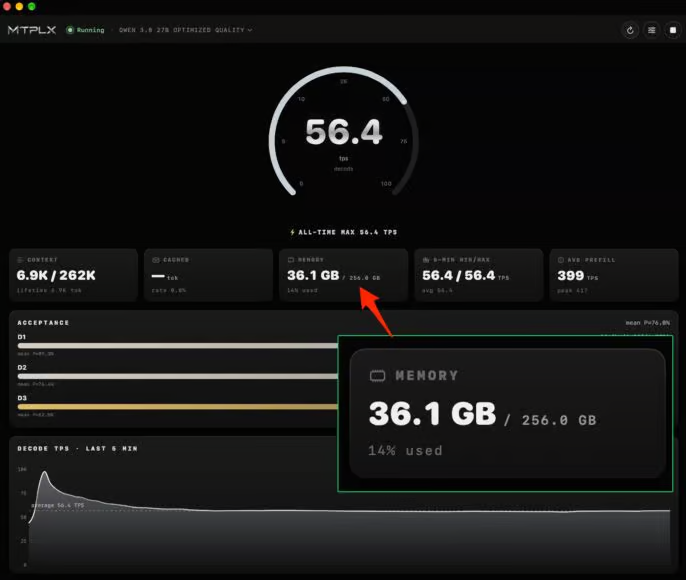
▲ M3 Ultra 跑 Qwen 3.8 27B Optimized Quality 時,Dashboard 顯示約使用 36.1GB 記憶體。
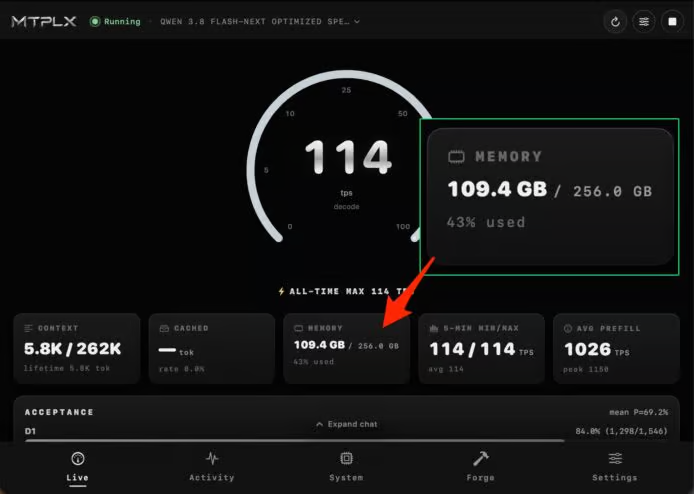
▲ M5 Ultra 跑 Qwen 3.8 Flash-Next Optimized Speed 的相近測試畫面,記憶體使用量約 109.4GB。
升級考量與適用場景
對於日常工作涉及大量本機端程式碼除錯、長文本處理或本地 AI 開發的專業用戶,Mac Studio M5 Ultra 在 100GB 以上模型中帶來的流暢度改善,能有效降低等待延遲;其多用途工作站特性亦兼顧剪輯、渲染與日常高效能計算需求。
然而,該設備的入門與客製化成本極為昂貴,且統一架構在出廠後無法進行硬體內部擴充。對於已持有 M3 Ultra 且僅偶爾使用本地 AI 的用戶而言,現有設備仍具備充足運算能力,是否升級需視高負載工作流程的實際效益而定。
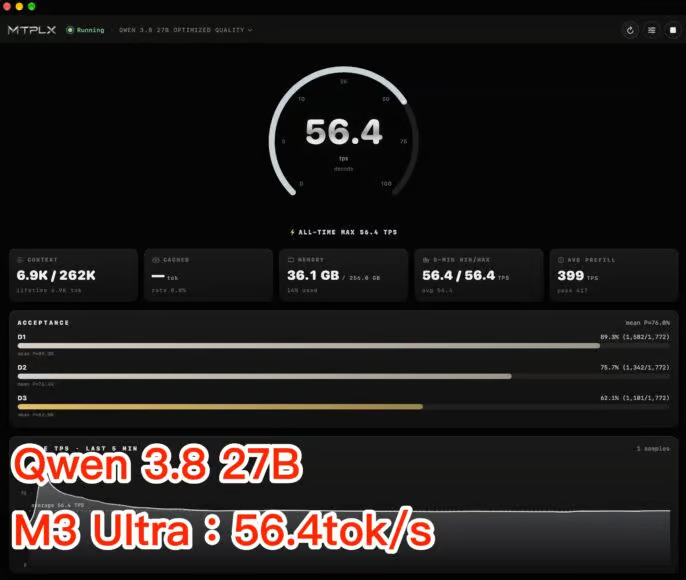
▲ M3 Ultra 跑 Qwen 3.8 27B,主要測試錄得 56.4 tok/s。
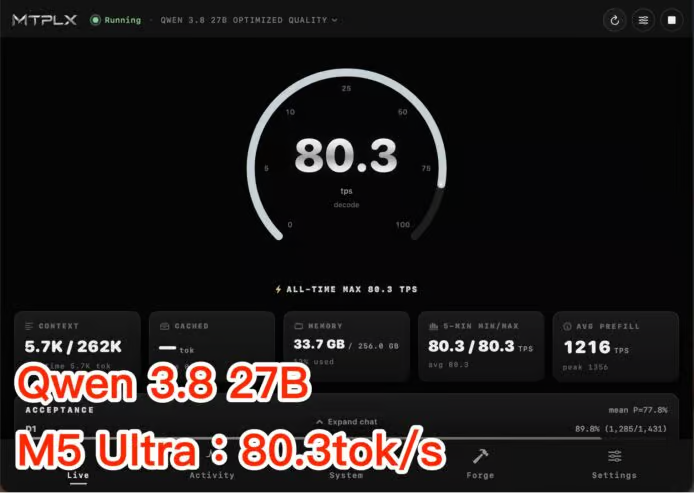
▲ M5 Ultra 同一款 27B 模型錄得 80.3 tok/s,比 M3 Ultra 提升約 42%。
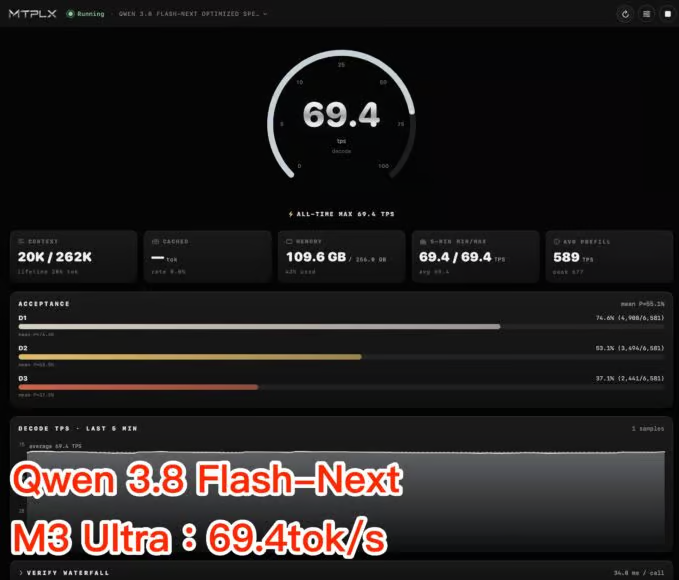
▲ M3 Ultra 跑 Qwen 3.8 Flash-Next 錄得 69.4 tok/s。
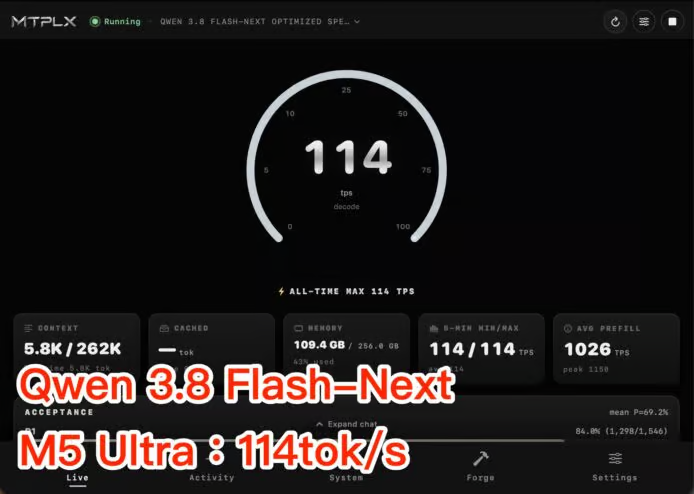
▲ M5 Ultra 同一款 Qwen 3.8 Flash-Next 模型錄得 114 tok/s,比 M3 Ultra 提升約 65%。
Reference Link : unwire.hk