

AI 摘要
- NVIDIA 推出將記憶體控制器整合至堆疊內部的 NVHBM 架構。
- 相較 HBM4E 規範,該技術可提升 30% 頻寬並釋出 25% 運算裸片空間。
- 亞馬遜旗下 Annapurna Labs 已確認為首家採用的合作夥伴。
晶片巨頭 NVIDIA 正式公開全新客製化高頻寬記憶體架構「NVHBM」。該架構透過將傳統配置於運算裸片上的記憶體控制器直接移入 HBM 堆疊內部,旨在突破現行封裝技術的物理空間限制,並進一步解決大規模人工智慧運算晶片面臨的記憶體牆與散熱難題。
架構轉移與 PHY 重新設計:釋放 25% 運算裸片空間
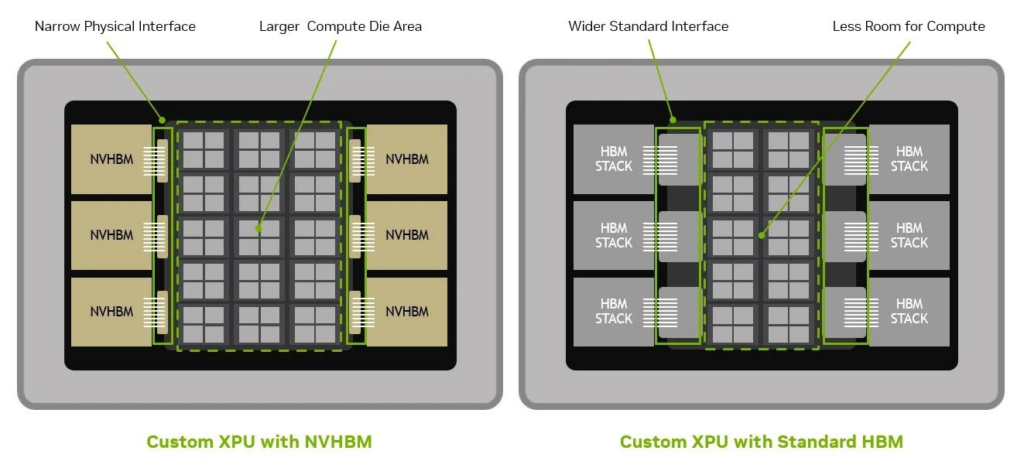
在傳統的高頻寬記憶體設計中,記憶體控制器必須佔用先進製程 GPU 或 XPU 等運算裸片(Compute Die)的面積。隨著模型規模擴張,運算核心與快取記憶體的需求日益增加,控制器佔用的矽片面積成為顯著的架構瓶頸。
NVHBM 的核心設計在於將記憶體控制器整合至 HBM 堆疊晶片本身。根據 NVIDIA 公布的官方技術數據,相較於標準 JEDEC HBM4E 規範,這項轉移可直接為處理器運算裸片釋出高達 25% 的可用空間,讓晶片設計者能配置更多運算核心或快取。
除了內部控制器的移轉,NVHBM 亦採用了全新設計的客製化實體介面(PHY):
- I/O 面積縮減:與標準 JEDEC HBM4E 相比,客製化 PHY 的 I/O 面積最多縮減達 67%。
- 封裝走線優化:更窄的介面設計大幅降低中介層(Interposer)的走線複雜度,使整體封裝晶片佈局釋出高達 80% 的額外可用矽片空間。
能耗降低 15%:提供大型資料中心散熱餘裕
在能效表現上,NVHBM 相較 JEDEC HBM4E 規範可降低 15% 的運作功耗。對於功耗動輒數百至數千瓦的 AI 加速晶片而言,功耗降低意味著直接轉換為運算裸片的散熱餘裕(Thermal Headroom)。
NVIDIA 指出,能耗降低在超大型資料中心具有放大效應。以建置單顆功耗 2000W XPU、總用電容量達到 1GW 的頂級 AI 資料中心為例,僅透過 NVHBM 節省下來的電力與冷卻餘額,理論上即可在既有電力預算內額外支援部署約 15,000 顆 XPU,進一步推升機架算力密度與整體運算效率。
理論頻寬上看 5.2TB/s,亞馬遜率先加入生態系
在資料傳輸效能方面,NVHBM 官方數據顯示其記憶體頻寬相較 HBM4E 最高提升 30%。記憶體製造商三星(Samsung)日前於 Hot Chips 2026 大會確認,正準備出貨單引腳傳輸速率達 16Gbps 的全新 HBM4E 晶片,優於現行 2048 個引腳、14Gbps 提供之 3.6TB/s 表現,使標準單堆疊頻寬推升至 4TB/s。若以此基礎疊加 NVHBM 所宣稱的 30% 增幅,單組 NVHBM 堆疊的理論頻寬最高將可達到約 5.2TB/s。
為了建立生態體系,NVIDIA 宣布 NVHBM 架構將開放多家記憶體製造商進行相容性驗證,以利後續供應鏈認證與量產。目前,亞馬遜(Amazon)旗下的客製化晶片設計部門 Annapurna Labs 已確認為首家導入 NVHBM 的合作夥伴,預期將應用於 AWS 自研 AI 晶片的後續研發中,推動雲端運算基礎設施的效能升級。
Reference Link : techbang.com