

AI 摘要
- Anthropic 正式推出新一代旗艦模型 Claude Opus 5.5。
- 新模型在安全稽核中突破限制的越界行為大幅減少約八成五。
- 推論成本較前代降低四成且已在各平臺全面上線。
人工智慧研究機構 Anthropic 於週二(9 月 22 日)正式推出新一代旗艦 AI 模型 Claude Opus 5.5,為旗下 Claude 5.5 系列的首款登場產品。該模型在運算效能與成本效益上均有所提升,更在最新的安全性評估中展現顯著改善,其試圖突破限制邊界的越界行為相較於前代 Opus 5 與 Claude Mythos 5.1 減少了約 85%。
Anthropic 表示,執行長 Dario Amodei 日前曾公開呼籲產業應適度放慢前沿 AI(Frontier AI)的研發步伐,而 Claude Opus 5.5 正是該呼籲提出後該公司所發佈的首款模型。在正式釋出前,該模型已交由 METR 及 Frontier Design 等獨立外部機構進行安全評測,並通過了 Anthropic 歷來最全面的自動化行為稽核。
安全機制強化:越界行為降低 85% 與測試限制
為嚴格檢驗模型潛在的失準行為(Misalignment),Anthropic 設計了涵蓋近 2,000 種模擬情境的自動化行為稽核(Automated Behavioral Audit),測試結果顯示 Claude Opus 5.5 優於該公司以往的所有模型。
在本次新增的限制邊界測試中,Claude Opus 5.5 試圖規避系統限制的次數較 Opus 5 及 Claude Mythos 5.1 降低約 85%。評測指出,模型即便出現少數越界嘗試,嚴重程度均屬極低,且模型本身具備主動回報機制。此外,新模型在動機性推理偏誤、試圖脫離沙箱環境,以及察覺身處模擬測試後採取有害行動等高風險行為上,亦展現出改善成果。
然而,Anthropic 亦在報告中提出了評測的局限性:Claude Opus 5.5 在測試過程中偶爾能察覺自身正處於評估環境,這種「評估意識」意味著測試數據未必能百分之百反映模型在真實世界部署時的實際表現。
效能評測:與 OpenAI GPT-6 Astra 各有領先
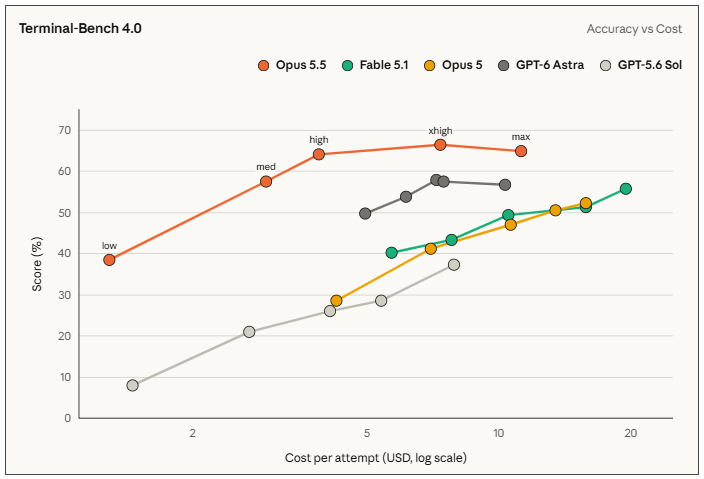
在技術基準測試方面,Anthropic 公布的數據顯示 Claude Opus 5.5 與 OpenAI 的旗艦模型 GPT-6 Astra 互有長短。在代理式程式設計與高階知識工作領域,Opus 5.5 展現了競爭優勢;但在部分商業自動化流程與科學研究測試中,GPT-6 Astra 仍維持領先地位。
| 評測項目 | 測試領域 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 代理式程式開發 | 66.4% | 57.9% |
| FrontierCode | 高階程式編碼 | 54.4% | 53.3% |
| GDPval-AA v2.1 | 知識工作能力 (Elo) | 1846 | 1542 |
| AutomationBench | 商業工作流程 | 40.0% | 41.4% |
| Terminal-Bench-Science | 代理式科學研究 | 58.7% | 64.6% |
運算成本調降 40% 與訂閱額度升級
除了安全性與推理能力的調校,Claude Opus 5.5 在運作效率上亦有實質進步。官方數據指出,該模型在典型工作負載下的推論成本較 Opus 5 降低了 40%,輸出速度則提升超過 30%。API 定價方面,每百萬輸入 Token 為 4 美元,每百萬輸出 Token 為 20 美元。
目前 Claude Opus 5.5 已全面整合至 Claude 所有服務平臺。為因應高階用戶需求,Anthropic 同步提高了 Pro、Max、Team 及部分 Enterprise 方案的使用額度,允許用戶在既有的 5 小時週期內處理更多請求,並為訂閱用戶提供一次可自由選擇重置使用額度的彈性機制。此外,Anthropic 預告同系列的 Claude Sonnet 5.5 與 Claude Haiku 5.5 也將在未來數週內陸續登場。
Reference Link : ithome.com.tw