

AI 摘要
- 英特爾正式發表代號 Crescent Island 的英特爾 GPU D 系列加速卡,專為 AI 推論設計並採用 Xe3P 架構。
- 單卡具備 350W 功耗與 1.3 PetaFLOPS FP8 算力,最高可搭載 480 GB LPDDR5X 記憶體且採標準風冷設計。
- 結合 Xeon 伺服器架構與 Enterprise Agent Toolkit,無須重寫 x86 程式碼即可直接擴充推論運算。
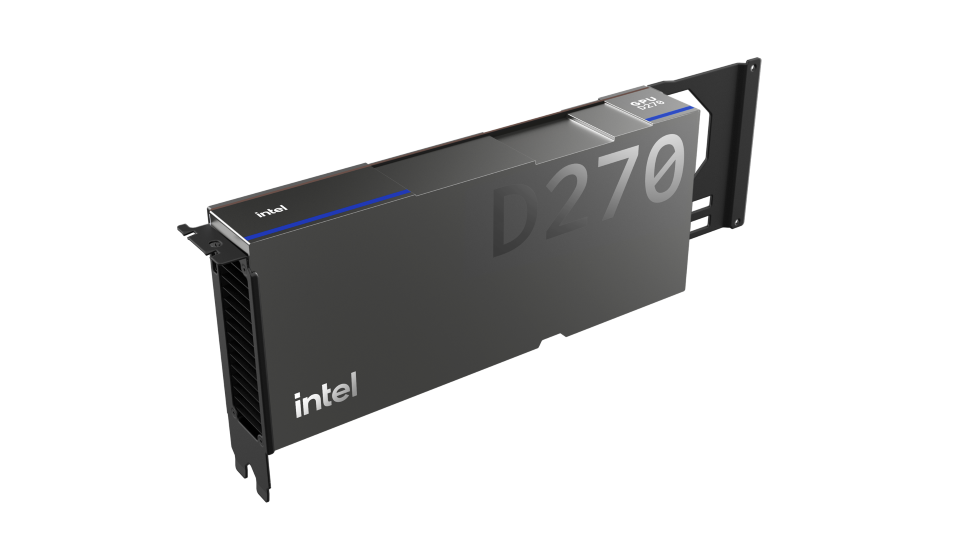
半導體大廠英特爾(Intel)正式公開旗下英特爾 GPU D 系列加速卡的技術細節。該產品代號為「Crescent Island」,專為 AI 推論(AI Inference)與代理型 AI(Agentic AI)工作負載打造,採用全新 Xe3P 架構,具備最高達 480 GB 的 LPDDR5X 記憶體容量,並維持標準 PCIe 規格與傳統空氣冷卻設計,大幅降低企業部署大型語言模型的基礎設施門檻。目前英特爾已向伺服器合作夥伴發送硬體樣品,正式零售價格尚未公布。
全新 Xe3P 架構專注推論運算
英特爾表示,英特爾 GPU D 系列加速卡完全移除顯示輸出功能,將所有晶片面積集中於純運算。硬體配置包含 32 個 Xe3P 核心、256 個向量引擎,以及 256 個經過重新設計、支援 16 深度脈動處理(16 deep systolic processing)的 XMX 引擎。此加速卡運行於 350W 功耗範圍內,可提供高達 1.3 PetaFLOPS 的 FP8 算力,並廣泛支援從 FP4 至 FP64 的資料格式。此外,卡上還整合了包含 4 個編碼器與 4 個解碼器的媒體引擎,專責視訊串流與解析處理。
超大記憶體容量:單卡支援 3,000 億參數模型
為因應龐大參數規模的 AI 模型,該加速卡採用頻寬達 1.5 TB/s 的 LPDDR5X 記憶體架構。英特爾原廠型號配置 160 GB 記憶體,而合作夥伴方案最高可提供至 480 GB。在單卡運作下即可負載高達 3,000 億(300B)參數的 AI 模型;若將 8 張卡串聯為單一集群,運算容量更可支援超過 1 兆(1T)參數的超大型模型。
| 規格項目 | 英特爾原廠配置 | 合作夥伴最高配置 |
|---|---|---|
| 記憶體容量 | 160 GB LPDDR5X | 480 GB LPDDR5X |
| 記憶體頻寬 | 1.5 TB/s | 1.5 TB/s |
| 單卡支援模型參數 | 高達 3,000 億(300B) | 高達 3,000 億(300B) |
| 8 卡集群支援參數 | 超過 1 兆(1T) | 超過 1 兆(1T) |
| 散熱與外觀規格 | PCIe 風冷散熱 | PCIe 風冷散熱 |
| 功耗與算力 | 350W / 1.3 PetaFLOPS (FP8) | 350W / 1.3 PetaFLOPS (FP8) |
整合 Xeon 伺服器架構與開放生態系
在系統整合方面,英特爾同步將該加速卡與符合 Open Compute Project(OCP)Open Rack v3 規範的 Xeon 伺服器結合。Xeon 6+ 機架配置最高可擴充至 46,000 個 CPU 核心,總機架功耗為 133.45 kW。在此架構下,Xeon CPU 負責資料路由、Token 編排(Token Orchestration)與背景記憶體管理,穩定為加速卡供應資料。英特爾亦提供開放轉接卡(Open Adapter Card)規格,協助雲端服務商在不變動電源與散熱設計的情況下整合第三方硬體。
軟體生態方面,基於共用 Xe 軟體平台,該卡已具備 Meta Muse Glimmer 等早期模型支援。透過 Intel AI for Enterprise Agent Toolkit 開放框架,專為 Xeon 處理器開發的程式碼無須全面重寫,即可直接在 GPU 上執行,協助資料中心在沿用既有 x86 基礎設施的同時擴充推論效能。
Reference Link : technews.tw