

AI 摘要
- Meta 正式推出旗艦模型 Muse Wonder Full,具備 100 萬 Token 上下文與 Active Memory、Active Focus 功能。
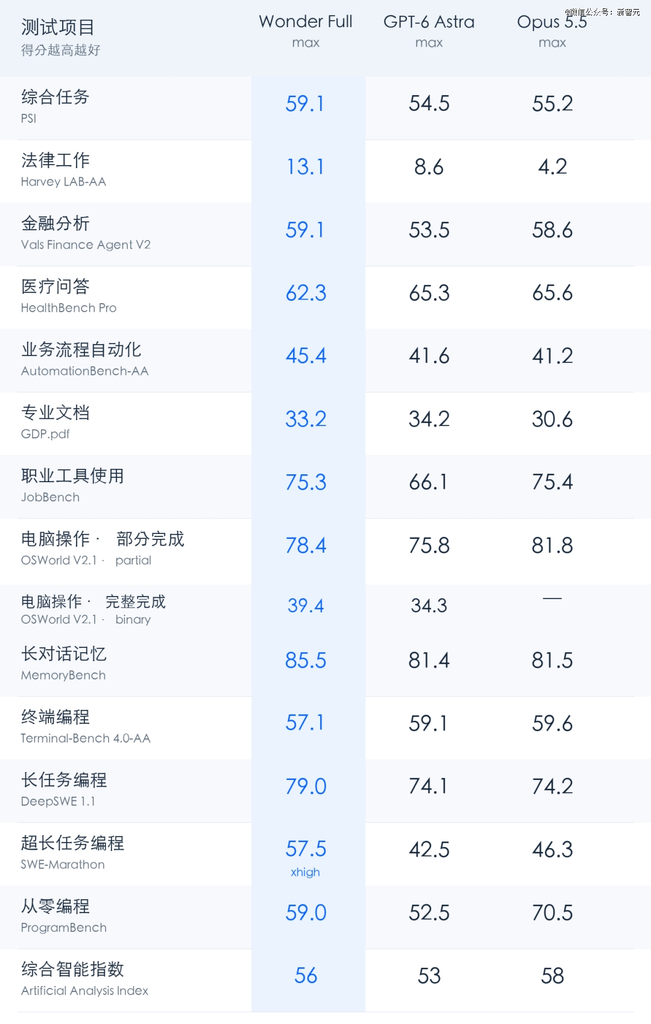
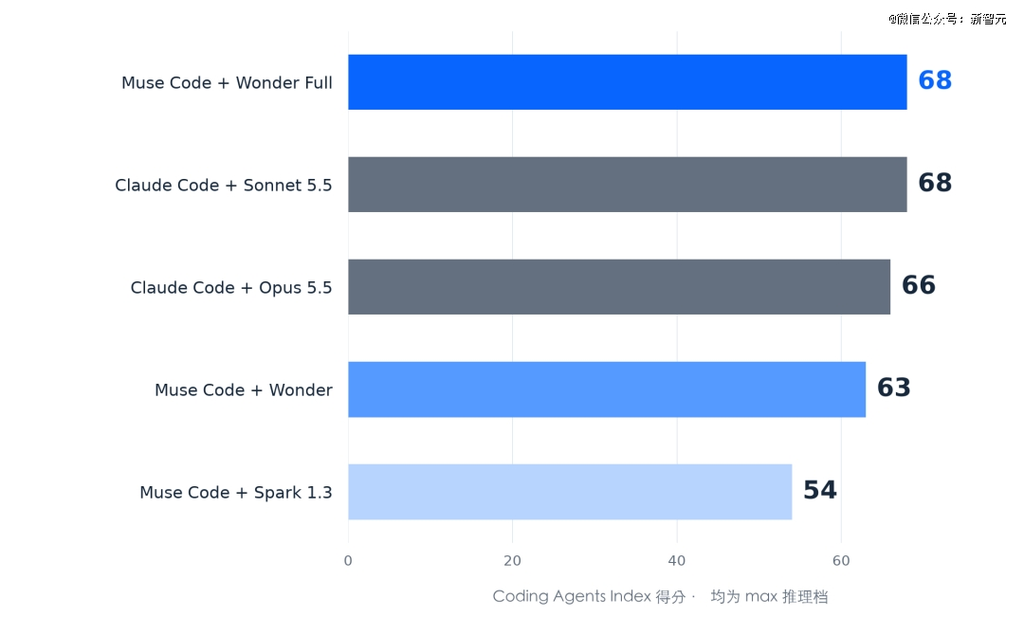
- 在 SWE-Marathon 長任務編程測試中取得 57.5% 成績,並在 AA 編程 Agent 榜取得 68 分。
- Muse Wonder Full 透過 Muse Code 提供每月 50 美元與 200 美元之訂閱方案,標準版則開放 API 使用。
Meta 正式推出旗下最新旗艦大模型 Muse Wonder Full 與標準版 Muse Wonder,官方將其定位為邁向個人超級智能的重要進展,主打長任務處理、全模態輸入以及高階程式開發能力。
技術架構與核心功能升級
Muse Wonder Full 具備高達 100 萬 Token 的推理上下文窗口,支援原生全模態輸入,可直接處理文字、高解析度圖像、長影片與連續音訊。該模型整合了兩大關鍵特性:Active Memory(主動記憶)與 Active Focus(主動專注)。Active Memory 能夠跨對話保存使用者關鍵資訊,而 Active Focus 則讓模型在遇到執行障礙時自主調整方案、在出錯後主動檢查,並根據新需求修正計畫。
長任務編程與基準測試數據對比
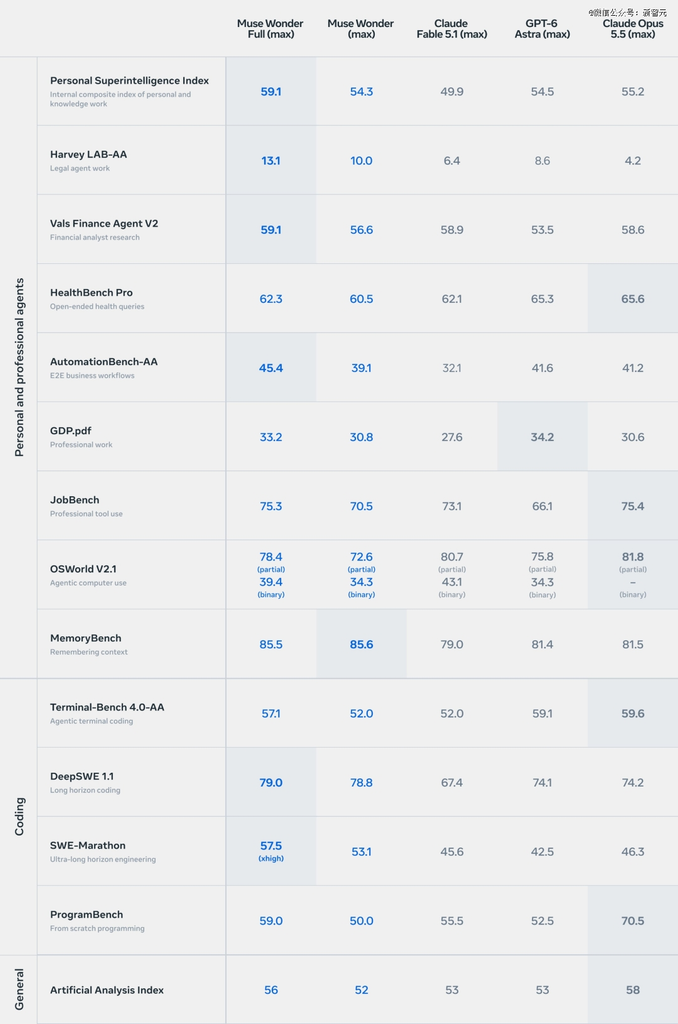
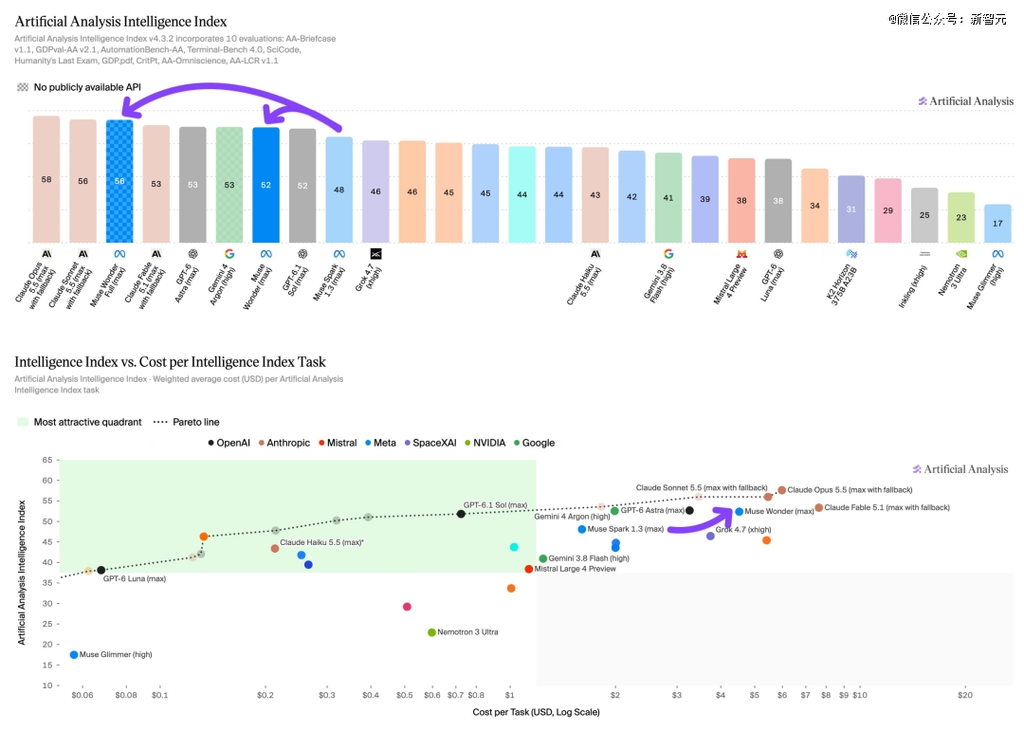
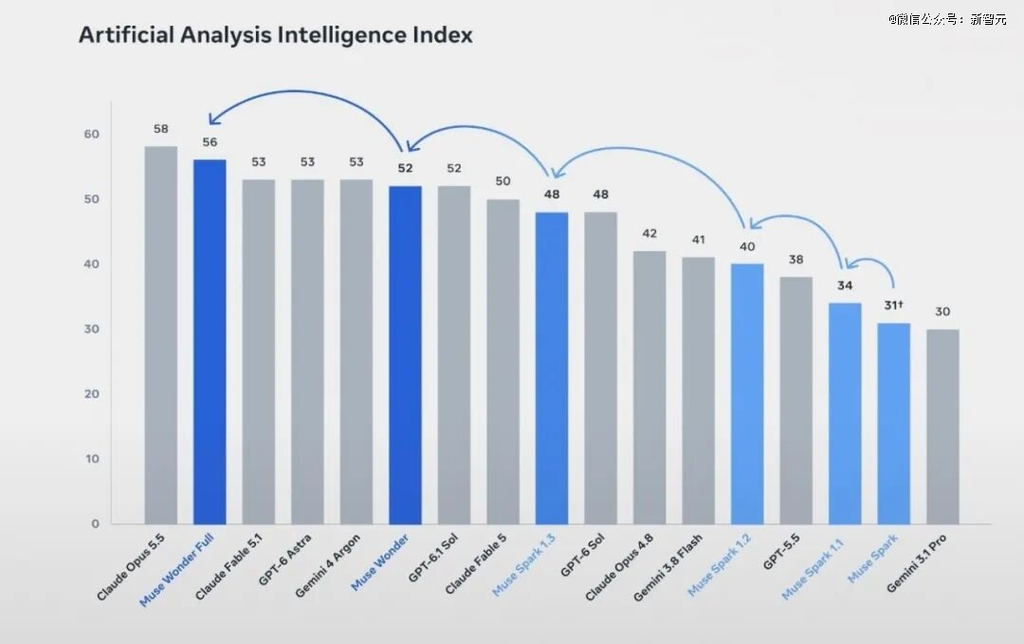
在 Artificial Analysis 綜合評測中,Muse Wonder Full 獲得 56 分,標準版 Muse Wonder 獲得 52 分。在長程任務基準 SWE-Marathon 以及多語言代碼評測 DeepSWE v1.1 中,Muse Wonder 系列展現出優異成績:
| 模型名稱 | SWE-Marathon 得分 | DeepSWE v1.1 得分 | AA 編程 Agent 榜得分 |
|---|---|---|---|
| Muse Wonder Full | 57.5% | 79.0% | 68 |
| Muse Wonder | 53.1% | 78.8% | 63 |
| Claude Opus 5.5 | 46.3% | 74.2% | 66 |
| GPT-6 Astra | 42.5% | 74.1% | 未提供 |
專業領域表現與幻覺率控制
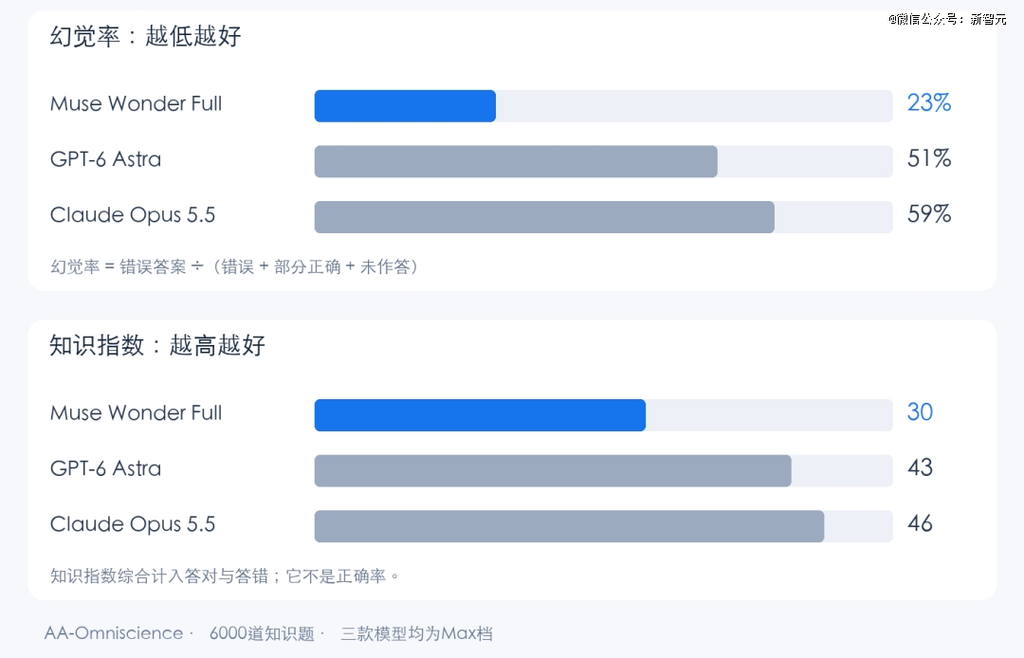
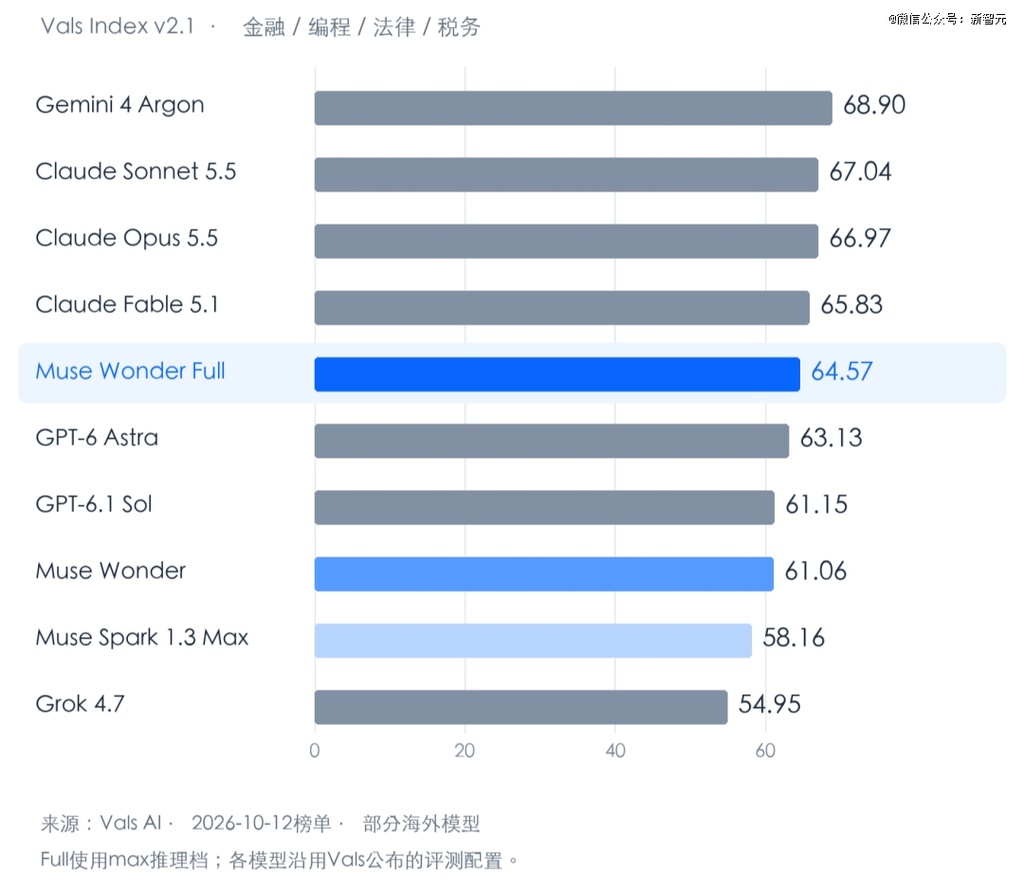
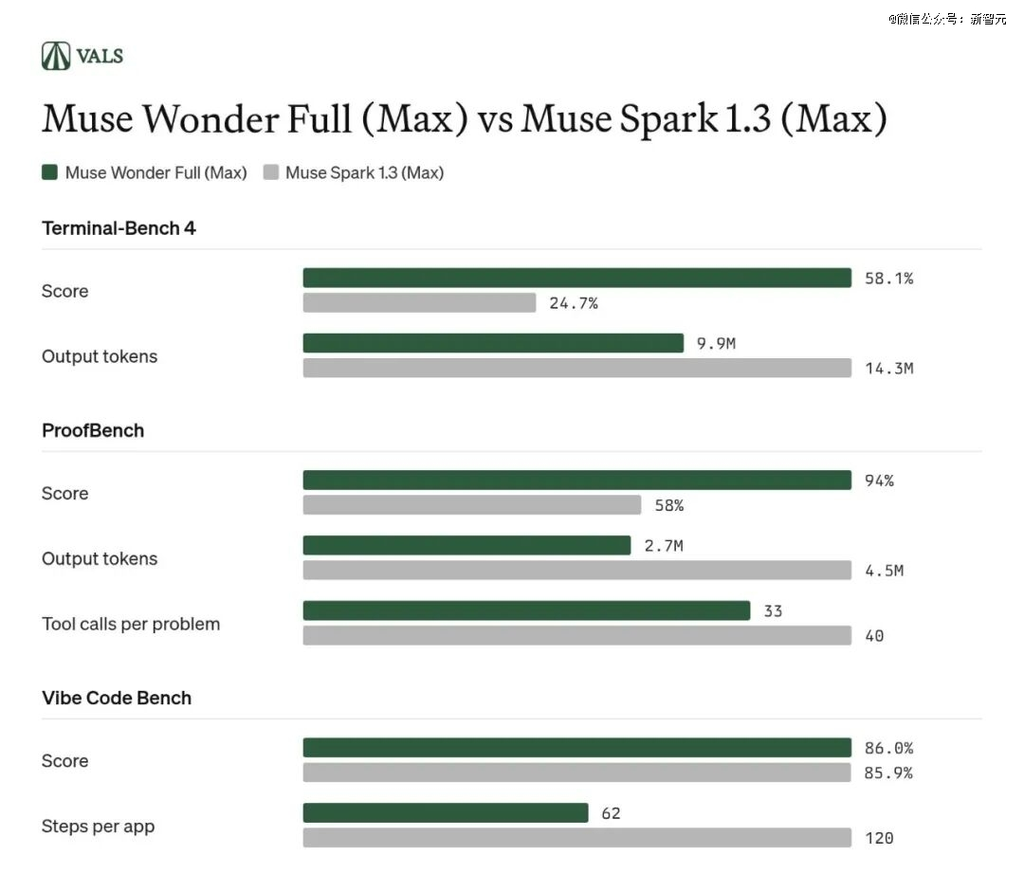
在專業工作評測中,Muse Wonder Full 於法律任務 Harvey LAB-AA 取得 13.1 分,金融任務評測取得 59.1 分。在 Artificial Analysis 的 6,000 道知識題測試中,Muse Wonder Full 的未答對題目錯誤回答比例(幻覺率)為 23%,低於 GPT-6 Astra 的 51% 與 Opus 的 59%。此外,在 Vals AI 的 ProofBench 數學證明測試中,該模型答對 94 道題目,輸出 Token 消耗相較前代減少約四成。
方案定價與發佈管道
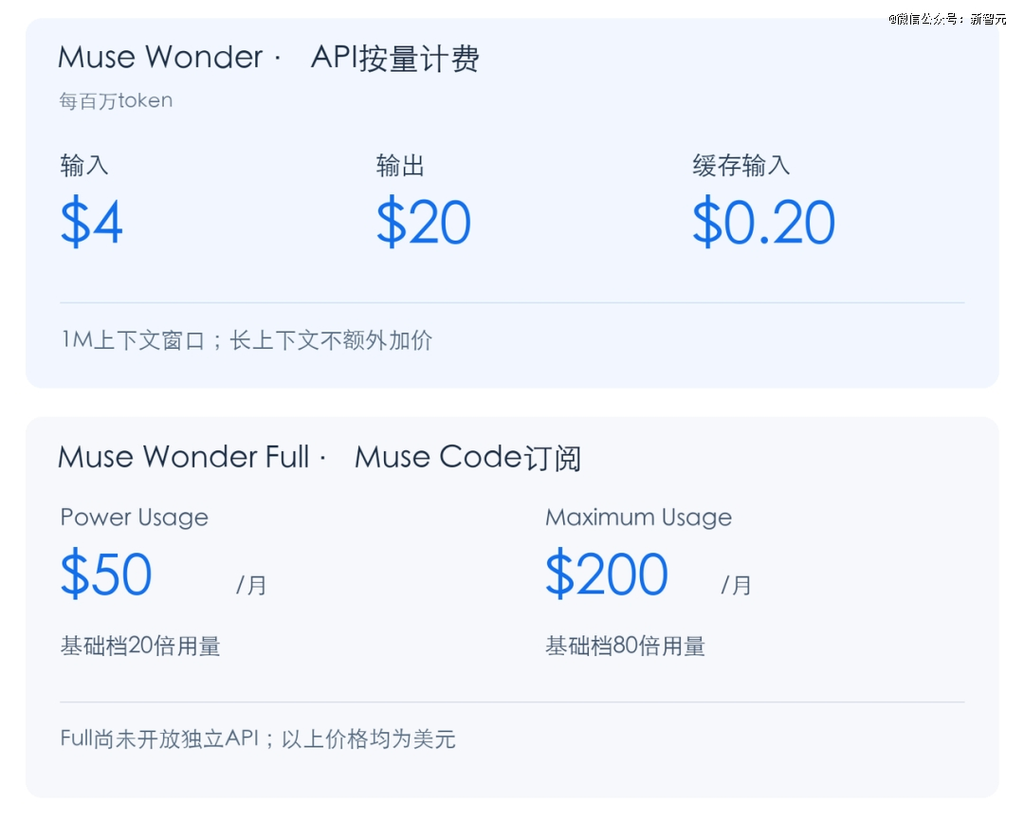
標準版 Muse Wonder 已於 Meta Model API 與 Muse Code 上線,API 定價為每百萬 Token 輸入 4 美元、輸出 20 美元,快取輸入為 0.20 美元,100 萬 Token 長上下文不額外加價。旗艦版 Muse Wonder Full 目前透過 Muse Code 訂閱開放,Power Usage 方案為每月 50 美元,Maximum Usage 方案為每月 200 美元,目前暫未開放獨立 API。
Reference Link : finance.sina.com.cn