

AI 摘要
- Mistral 推出擁有 1.05 兆參數的 Mistral Large 4 公開預覽版。
- 模型採用細粒度 MoE 與原生多模態架構,並預計於 10 月底釋出權重。
法國人工智慧新創 Mistral 於週二(10/6)正式發布 Mistral Large 4(ML4)公開預覽版。該模型為該公司迄今規模最大、效能最強的旗艦模型,採用細粒度混合專家(Mixture of Experts, MoE)架構,總參數達到 1.05 兆,在每次推理過程中僅啟用 490 億個參數。第三方評測機構 Artificial Analysis 評估指出,這是目前在美國與中國之外整體表現最強的模型;Mistral 官方則表示,ML4 也是歐美所開發的最佳開放權重(Open-weight)模型。
細粒度 MoE 與原生多模態架構規格
Mistral Large 4 原生支援多模態輸入,具備同時處理文字與圖像的能力。該模型內建 16 億參數的視覺編碼器(Vision Encoder),上下文視窗(Context Window)支援高達 100 萬個 Token,並涵蓋超過 160 種語言。目前開發者已可透過 Mistral Studio 與官方 API 存取此模型,其模型權重預計將於 10 月底正式開放下載。
在基礎設施方面,ML4 完全由 Mistral 自有歐洲資料中心訓練而成,使用 3,800 張 Nvidia Grace Blackwell GPU 從零開始建置。Mistral 強調,該架構設計符合歐洲資料主權規範,未來支援部署於私有雲或企業內部地端環境,亦可由 Mistral 於歐洲境內代管運作。
基準測試數據:資安防護與程式開發表現
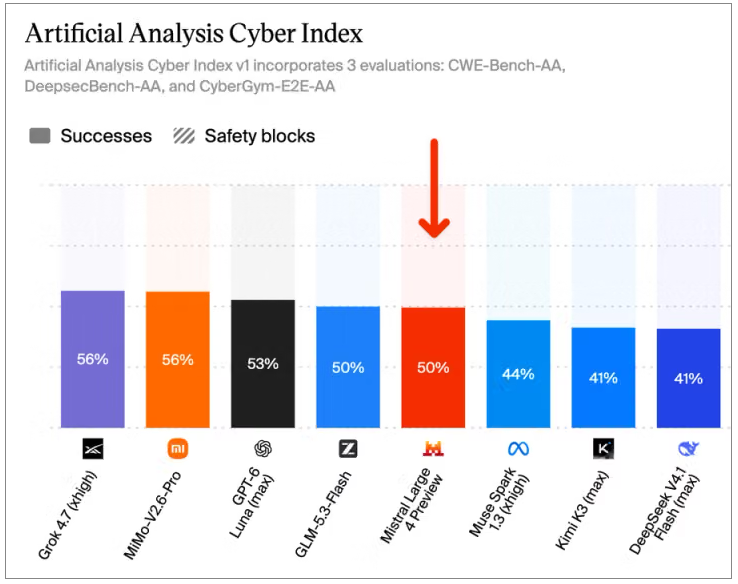
Mistral 公布了多項基準測試結果,顯示 ML4 在資安研究、軟體開發與 AI 代理人(Agent)工作流具備競爭力。然而官方也指出,各項測試中所對照的模型基準並非完全一致:
- 資訊安全能力:引述 Artificial Analysis 評測數據,ML4 於 Cyber Index 排名全球前五名。在要求模型重現並修補開源軟體漏洞的 CyberGym-E2E-AA 測試中達到 82%,居所有受測模型之冠;在資安競賽題目基準 Cybench 中則成功解出 93% 的題目。
- 軟體工程與自動化:在 DeepSWE v1.1 評測中取得 61.7%,高於 DeepSeek V4 Pro 0813 與 Qwen 3.8 Max;在涵蓋 657 項企業工作流程的 AutomationBench 獲得 59.9%,領先 Kimi K3 與 MiMo-V2.6-Pro。
- 視覺定位基準:在檢驗複雜影像物件定位能力的 Dense 200 測試中取得 42%,略高於 GPT-6 Astra 的 41%。
綜合效能評估與 API 成本考量
根據 Artificial Analysis 的綜合評估,ML4 的 Intelligence Index 獲得 38 分,與 GPT-6 Luna(max)的 38 分同級,並緊追 DeepSeek V4.1 Flash(max)的 39 分。
不過在推論成本方面,ML4 定價相對較高。其官方標準 API 價格設定為每 100 萬個輸入 Token 為 1.36 美元、輸出 Token 為 4.18 美元。Artificial Analysis 計算指出,平均執行單項 Intelligence Index 任務的成本約為 1.13 美元,約為 GLM-5.3-Flash 與 DeepSeek V4.1 Flash 的 4 倍。對於重視運算成本與高併發需求的企業用戶而言,成本效益將是導入評估時的重要指標。
Reference Link : ithome.com.tw