

AI 摘要
- 微軟推出專門處理判斷與分類的決策模型 Microsoft-Decision-1。
- 模型以 Qwen3.5-9B 為基礎訓練,平均準確率達 83.5%。
- 該模型已於 Microsoft Foundry 與 OpenRouter 上線提供付費 API 服務。
微軟正式推出專門為 AI 代理(AI Agent)及企業應用設計的全新決策模型 Microsoft-Decision-1,主打自動化分類、評分、工作分派與流程控管。有別於傳統以對話或文字生成為主的通用大型語言模型,Microsoft-Decision-1 採取單次推論完成決策評分,能根據使用者預先設定的選項計算各選項機率,並藉由結構化 API 回傳結果,協助企業系統決定下一步操作,例如分派工單、挑選適合的 AI 模型或觸發人工審查機制。
定位專用判斷架構:非生成式設計與 32K 上下文
Microsoft-Decision-1 的核心架構以阿里巴巴的 Qwen3.5-9B 為基礎,由微軟團隊進行後續微調與強化訓練。該模型並不提供自由文字聊天、文章生成或判斷理由輸出功能,其設計專注於降低推論延遲與提升決策一致性。在技術規格方面,該模型最多可處理 3.2 萬(32K)詞元(tokens)的輸入長度,支援是非題判斷、多選題選擇以及細緻的等級評分。
效能評測與同類競品比較
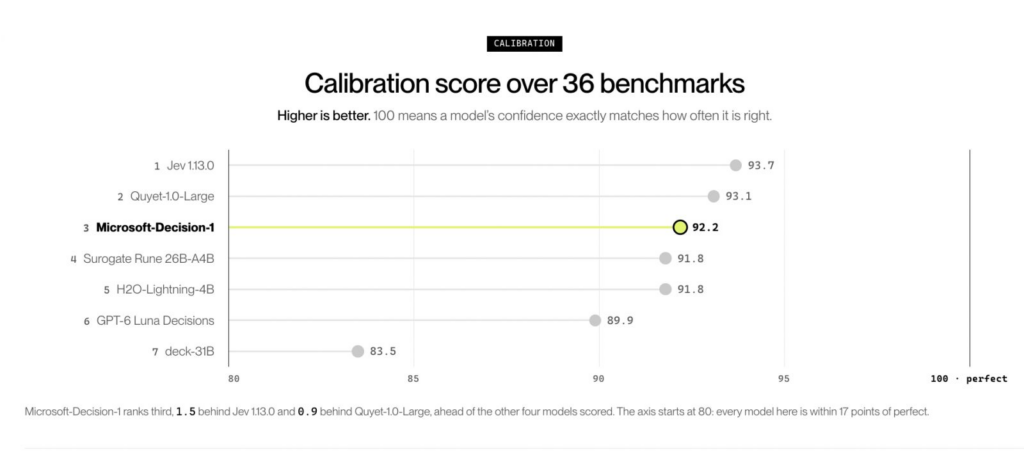
微軟公布了涵蓋分類、排序、多語言、推理及安全等範疇的 36 項基準測試,累計題數近 15 萬道。在微軟內部評測數據中,Microsoft-Decision-1 的平均準確率達到 83.5%,優於同類決策模型 Jev 1.13.0 以及 GPT-6 Luna Decisions。不過在衡量預測機率與實際結果吻合度的「機率校準評分」指標上,Jev 1.13.0 仍以 93.7 分略勝一籌。
| 模型名稱 | 平均準確率 | 機率校準評分 | 架構基礎 |
|---|---|---|---|
| Microsoft-Decision-1 | 83.5% | 92.2 分 | Qwen3.5-9B 微調 |
| Jev 1.13.0 | 82.3% | 93.7 分 | 未公布 |
| GPT-6 Luna Decisions | 79.4% | 89.9 分 | 未公布 |
穩定度測試與內部導入成果
針對提示詞變異的穩定性測試顯示,在面對改寫問題、調整選項順序及更換資料格式等 8 種情境時,Microsoft-Decision-1 平均僅有 1.3% 的判斷結果產生變動,且調整選項排列順序時並未對最終決策造成偏差。
在微軟內部實際應用上,Xbox Research 已導入該模型自動分類與整理超過 1 萬筆玩家反饋意見;Copilot 團隊亦採用此模型評估並檢查各類 AI 回覆的品質標準。
計費方式與未來發展路線
Microsoft-Decision-1 目前已正式於 Microsoft Foundry 及 OpenRouter 平台提供服務,計費模式以用量計價:每 100 萬個輸入詞元(Input Tokens)費用為 0.042 美元,輸出詞元則不另收費。微軟表示未來將持續推出更新版本,並規劃納入自家 MAI 架構及 OpenAI 技術基礎開發新一代決策產品。
Reference Link : ithome.com.tw