

AI 摘要
- 螞蟻集團百靈大模型宣佈開源 Ling-3.1-flash,具備約 560B 總參數、激活約 25B 參數,最高支援 1M 上下文。
- 透過 MXFP4 與 block-FP8 量化,權重縮減至 292GB,Hopper GPU 部署由 8 卡降至 4 卡。
- 輸出速度達每秒 210 Token,混合調用定價約每百萬 Token 0.19 美元。
10 月 15 日,螞蟻集團旗下百靈大模型宣佈正式開源 Ling-3.1-flash。作為百靈系列最新旗艦級開源模型,Ling-3.1-flash 主打「真實可用」,延續了混合線性架構設計,總參數約為 560B、每個 Token 激活約 25B 參數,最高支援 1M 超長上下文。該模型已在 Hugging Face 與 ModelScope 開放權重下載,致力於降低企業部署門檻,加速業務落地。
極致量化技術:Hopper GPU 部署門檻減半至 4 卡
針對大模型本地私有化部署的高昂硬體門檻,百靈團隊在 Ling-3.1-flash 上進行了深度量化優化。團隊對 routed experts 採用 MXFP4 量化,同時 dense 層保持 block-FP8,使模型權重佔用容量從約 534GB 大幅縮減至 292GB。在對應的 NVIDIA Hopper 架構 GPU 測試配置中,服務部署所需卡數由原本的 8 卡直接降至 4 卡,顯著減輕了企業部署 500B 級別大模型的硬體負擔。
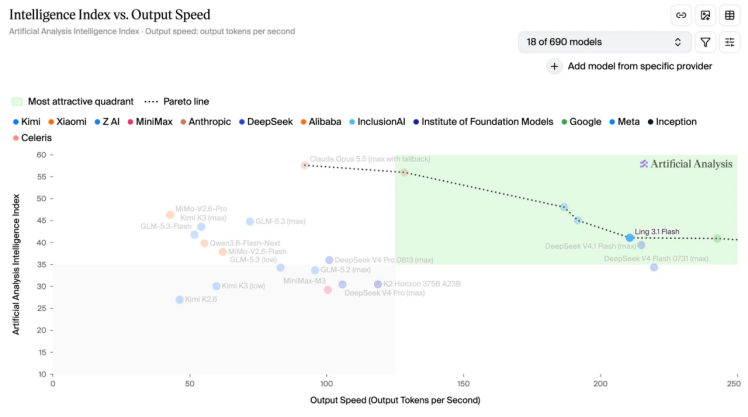
兼顧效能與成本:高「智效比」與每百萬 Token 0.19 美元定價
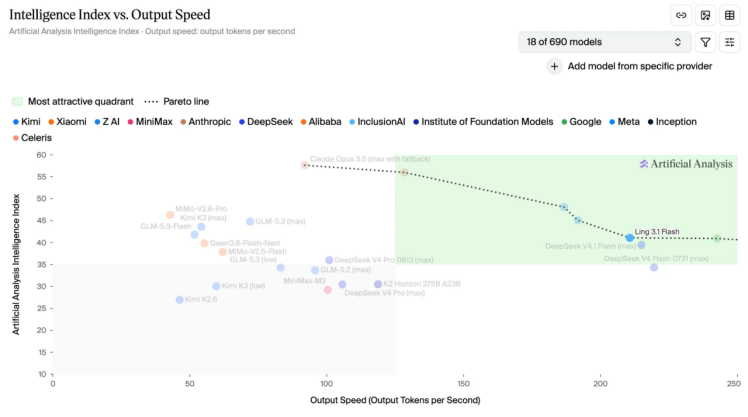
百靈大模型系列一貫重視「智效比」,Ling-3.1-flash 在輸出速度與推論成本方面均展現高度競爭力。在 Artificial Analysis 的公開評測中,Ling-3.1-flash 取得 41 的智能指數,生成速度約為每秒 210 Token。在 API 調用成本方面,其混合調用價格約為每百萬 Token 0.19 美元,精準鎖定需要高頻調用、低延遲反應的企業知識助手與代碼輔助場景。
Ling-3.1-flash 核心規格與技術指標一覽
| 評測項目/技術規格 | Ling-3.1-flash 表現與參數 |
|---|---|
| 總參數規模 | 約 560B(混合線性架構) |
| 單 Token 激活參數 | 約 25B |
| 最大上下文視窗 | 最高支援 1M |
| 模型權重大小 | 未量化約 534GB / 量化後(MXFP4+FP8)約 292GB |
| Hopper GPU 部署卡數 | 由 8 卡降至 4 卡 |
| 輸出速度 | 約 210 Token/秒 |
| Artificial Analysis 智能指數 | 41 |
| 混合調用價格 | 約 $0.19 美元 / 百萬 Token |
| 辦公基準評測(GDPVal-AA V2.1) | 1673 分(ELO) |
| 醫療場景評測(HealthBench Professional) | 65.35 分 |
全方位應對專業工作流:醫療、辦公與軟體工程落地
Ling-3.1-flash 專為複雜業務工作流打造,在多項領域基準測試中表現優異:
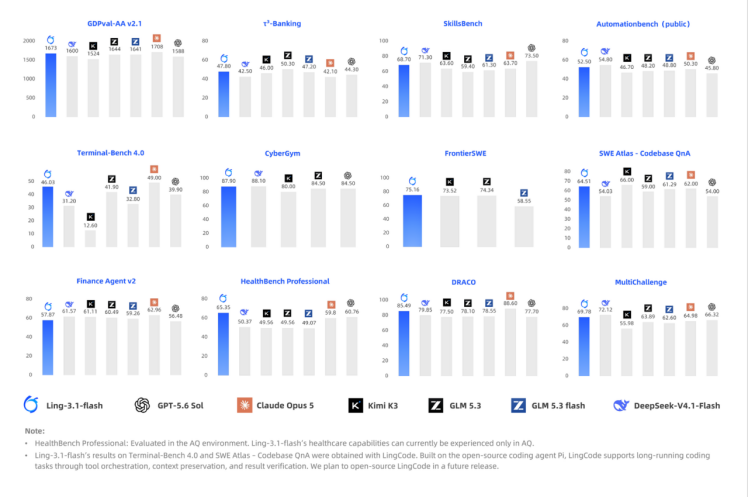
- 辦公任務:在 GDPVal-AA V2.1 評測中獲得 1673 分(ELO),具備處理分散資料並整理成報告與彙報材料的高效能力。
- 醫療健康:在 HealthBench Professional 醫療場景評測取得 65.35 分,可協助梳理零散症狀、病史與就診問題。
- 軟體工程與系統操作:在 FrontierSWE 與 Terminal-Bench 4.0 基準測試中,展現讀懂舊代碼、開發新功能並依測試修正的強大能力。
透過本次開源,螞蟻百靈進一步完善了從端側到雲端伺服器的開源生態佈局,為企業與開發者提供兼具性能、超長上下文與低部署成本的基礎模型選擇。
Reference Link : news.aibase.com