

AI 摘要
- Mozilla指中國開源權重模型與美國閉源模型差距約4.4個月。
- 中國模型在OpenRouter使用量高但收入仍落後閉源模型。
- Kimi K3的硬件需求令自行部署面臨高門檻。
非牟利機構 Mozilla 於9月15日發布《State of Open Source AI》1.1版報告,統計數據截至9月1日。報告指出,中國頂尖開源權重(open-weight)人工智能模型與美國閉源前沿模型的能力差距,已收窄至約4個月;部分模型雖然在基準測試仍稍遜,但使用成本明顯較低。
不過,Mozilla也提醒,「開放權重」不等同於嚴格定義下的開源,實際部署這些大型模型所需的硬件資源,可能令一般開發者及企業難以自行運行。
能力差距約4.4個月,開源模型成本較低
根據Mozilla引用的Artificial Analysis Intelligence Index數據,表現最佳的開源權重模型,評分只比閉源榜首低3分,但收費約為對方的60%;與Anthropic的Claude Fable 5比較時,相關模型落後2分,收費則約為其30%。
報告同時引用研究機構METR的數據。該機構以人工智能完成相當於人類所需工作時間的任務能力作為評估基礎,Mozilla據此推算,開源與閉源模型的能力差距約為4.4個月,與Epoch AI早前估算的4個月大致接近。
按照報告模型,閉源模型目前可以處理相當於人類專家8至12小時工作量的任務,開源模型則需要約4個月才能追上。報告亦指出,開源模型的能力約每3.9個月倍增一次,閉源模型則約每5.5個月倍增一次,顯示開源陣營的進步速度較快。
GLM-5.2測試成本不足競爭對手五分之一
在由vals.ai主導、使用統一測試環境的Terminal-Bench 2.1排行榜中,智譜AI(Z.ai)的GLM-5.2評分只比Anthropic的Claude Opus 4.7低1分,比Claude Opus 4.8低約4分。
然而,GLM-5.2每次測試的成本不足對手五分之一,反映模型能力差距與實際使用成本之間並非同步。
中國模型在OpenRouter受歡迎,但收入仍由閉源供應商主導
OpenRouter數據顯示,2025年8月按token用量計算的十大熱門模型中,有8個屬於開源權重模型,其中7個由中國企業開發。
不過,Linux Foundation統計顯示,在2025年5月至9月期間,閉源模型供應商仍佔OpenRouter模型層收入的96%,開源模型的使用量優勢尚未轉化為相應收入。
Mozilla技術總監Raffi Krikorian接受外媒Ars Technica訪問時表示,企業是否選擇付費使用閉源模型,取決於具體工作需要,而非機構的整體策略。
Mozilla本身支持開源模型,Krikorian早前也向《TIME》承認,相關報告帶有一定程度的「倡導」(advocacy)成分,因此報告結論需要配合其研究取向理解。
「開放權重」不等於完整開源
報告統計的16個「重要開源版本」中,沒有任何一個符合Open Source Initiative對「開源」的嚴格定義。
原因在於,開放權重通常只代表模型參數可以下載,並不代表訓練數據、完整程式碼或訓練流程同時公開。使用者可以取得模型權重,但未必能夠重現模型的訓練方式或完整檢視其資料來源。
硬件門檻可能遠高於API價格所反映的情況
Mozilla指出,報告所說的4個月能力差距及約三成價格,主要是以API對API、雲端主機及標準定價方式比較。若改以實際硬件需求評估,開源模型的可用性可能大幅降低。
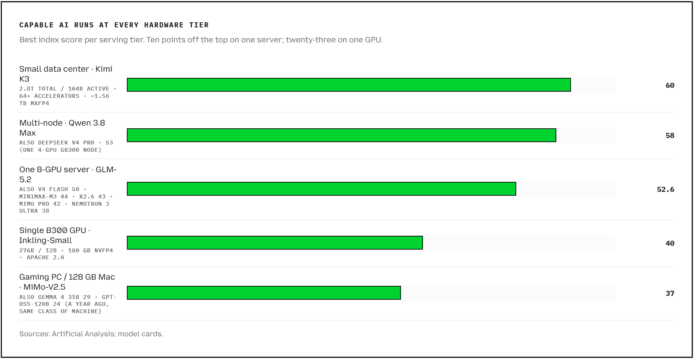
報告硬件圖表顯示,能在單一伺服器運行的最佳開源模型評分為52.6分,能在單一GPU運行的模型評分更只有40分,與頂尖水平相差約10至23分,差距明顯大於以時間計算的4個月。
以月之暗面(Moonshot AI)的Kimi K3原生MXFP4版本為例,模型檔案約1.56TB,需要分散於96個運算單元。Mozilla建議的部署配置需要64個以上加速卡;vLLM官方則建議至少使用8張Nvidia GB300 GPU,正式生產環境更需要多部伺服器。
Tom’s Hardware早於7月推算,Kimi K3的記憶體需求接近1.5TB。這意味着模型雖然以開放權重形式提供,但一般開發者及不少企業仍難以自行部署。
報告提到的少數例外包括Thinking Machines以Apache 2.0授權發布的Inkling-Small。其NVFP4版本最低只需要180GB記憶體,便可在單張B300上運行。
新評測數據已令模型排名重新洗牌
Mozilla報告截稿後,相關模型的排名已出現變化。Artificial Analysis已更新至4.3版指數,並採用新的評測方式。在最新數據中,Claude Fable 5.1於最高算力設定下取得53分,Kimi K3則為44分,因此不能直接與Mozilla報告引用的舊版數據比較。
vals.ai於9月11日更新的Terminal-Bench 2.1排行榜,則由OpenAI的GPT-6 Astra領先,得分為87.27%;Fable 5.1得分為85.02%。Mozilla在報告圖表註釋中也承認,每個模型發布週期都可能重新改變彼此差距。
Kimi K3面臨模型蒸餾指控
Kimi K3近期亦捲入訓練資料爭議。美國國家安全局(NSA)、網絡安全及基礎設施安全局(CISA)與聯邦調查局(FBI)於9月8日發布編號AA26-251A的聯合警告,指控月之暗面可能透過「蒸餾」(distillation)方式,利用另一個模型的輸出結果作為訓練材料,抽取Claude Fable 5的數據以訓練Kimi K3。
不過,Mozilla報告強調,相關指控目前只是單方面說法,尚未有實質證據證明。這意味着Kimi K3的能力表現、成本優勢與訓練資料來源,仍需要後續測試及更多公開證據確認。
開源模型競爭力不能只看模型分數
Mozilla的分析顯示,中國開源權重模型在API價格及部分基準測試上,已對美國閉源模型構成競爭。但模型實際價值仍取決於硬件需求、部署成本、授權條款、資料透明度及評測方法。
因此,所謂開源模型與閉源模型的差距,不能只用單一分數或時間估算概括。對企業而言,模型是否能在現有基礎設施中運行,以及相關供應商能否提供穩定服務,可能與排行榜上的能力差距同樣重要。
Reference Link : unwire.hk