

AI 摘要
- Meta 發表全新 Muse Wonder 系列旗艦 AI 模型,包含 Muse Wonder 與 Muse Wonder Full 兩款版本。
- 模型主打「主動記憶」與「主動專注」架構,專注於長流程任務執行與跨對話脈絡保留。
- Muse Wonder Full 在個人超級智慧指數取得 59.1 分,高於 Claude Opus 5.5 與 GPT-6 Astra。
Meta 正式發表全新旗艦 AI 模型系列 Muse Wonder,包含標準版 Muse Wonder 與高階版 Muse Wonder Full。該系列專為 AI Agent、跨對話記憶以及複雜的長流程任務執行量身打造,展現 Meta 推進「個人超級智慧」領域的最新技術成果,未來亦將逐步整合至旗下的各項 Muse 服務中。
雙核心能力:主動記憶與主動專注
Muse Wonder 系列主打兩項核心技術架構,旨在打破傳統大型語言模型僅能處理單次指令的局限:
- 主動記憶(Active Memory):模型能夠在跨對話的情境中保留與使用者及任務相關的背景資訊,並在合適時機主動取回所需細節,減少使用者重複輸入背景說明的繁瑣步驟。
- 主動專注(Active Focus):面對需要多個步驟的複雜工作時,模型具備嘗試多元解法、隨新資訊動態調整路徑並在遇到障礙時持續推進的能力,同時在關鍵操作加入確認機制以防範誤操作。
基準測試跑分與競品比較
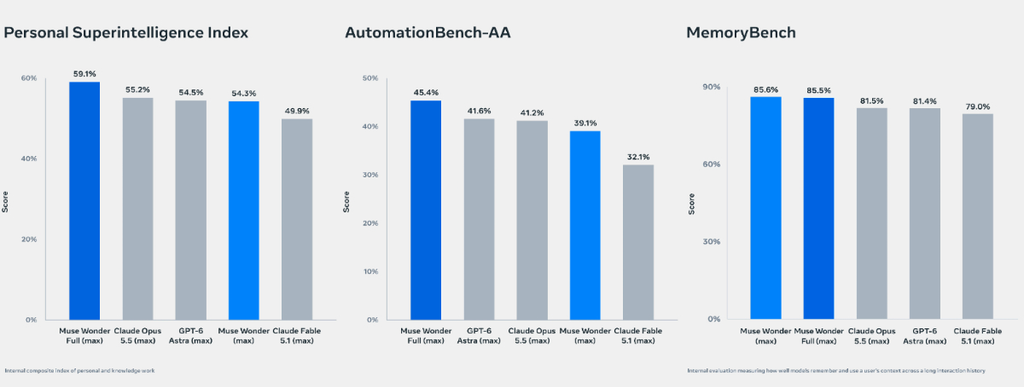
根據 Meta 公布的評測數據,Muse Wonder Full 在個人超級智慧指數(Personal Superintelligence Index)取得 59.1 分,超越了 Claude Opus 5.5 的 55.2 分與 GPT-6 Astra 的 54.5 分。而在自動化工作流程評測 AutomationBench-AA 中,亦繳出 45.4 分的領先表現。
| 評測項目 / 指標 | Muse Wonder | Muse Wonder Full | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| 個人超級智慧指數 (PSI) | – | 59.1 | 55.2 | 54.5 |
| AutomationBench-AA | – | 45.4 | – | – |
| MemoryBench (跨對話記憶) | 85.6 | 85.5 | – | – |
儘管在特定指標上取得領先,Meta 同時指出,在健康知識問答以及終端機程式開發等測試中,不同模型各有千秋,整體表現仍依具體應用場景而定。
專業知識領域與程式碼開發支援
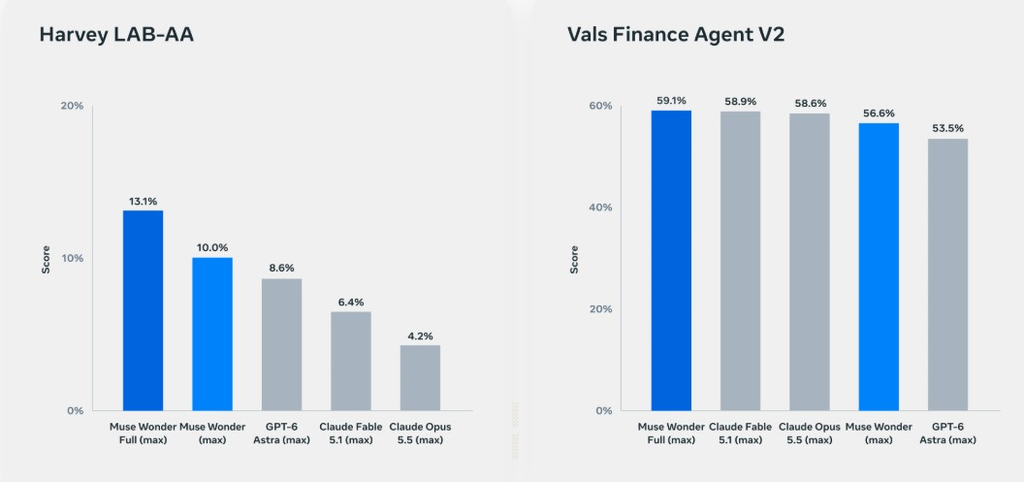
Muse Wonder 著重於法律、金融與健康等專業情境的深度應用,並採用 Harvey 的法律代理基準測試 LAB 進行評估。在程式開發方面,該系列能持續執行、測試並修正程式碼,支援從小工具至中大型軟體專案的開發週期。
安全防護架構與上線通路
針對 AI Agent 存取訊息、行事曆與私人文件的權限需求,Meta 為 Muse Wonder 系列構建了嚴格的防護機制,涵蓋防禦對抗指令、隱私資料過濾,以及化學、生物、放射性物質與核武(CBRN)和網路濫用風險防範。
目前 Muse Wonder 已透過 Meta Model API 與 Muse Code 提供;進階版本 Muse Wonder Full 則開放給 Muse Code 訂閱用戶使用,後續將陸續推展至更多個人助理情境。
Reference Link : techbang.com