

AI 摘要
- AI推論的長上下文與高併發請求推升動態資料量,導致KV Cache容易突破GPU HBM容量上限。
- 業界正利用通用CXL擴充可定址記憶體並推動池化架構,同時在AI推論領域測試分層儲存與KV Cache重載。
- CXL生態系帶動Retimer、交換器與控制器需求,供應鏈與伺服器ODM的平台整合複雜度顯著提高。
隨著人工智慧推論應用迅速朝向長上下文(Long Context)、多輪對話以及大規模併發請求(Concurrent Requests)發展,資料中心伺服器的記憶體子系統面臨前所未有的負載挑戰。過去以儲存模型權重為主的靜態需求,已轉變為由動態生成的鍵值快取(KV Cache)主導的容量瓶頸。業界正加速推進基於 Compute Express Link(CXL)的通用記憶體擴充方案,並在 AI 推論架構中評估導入選擇性記憶體分層技術。
長上下文與高併發放大 KV Cache 負載
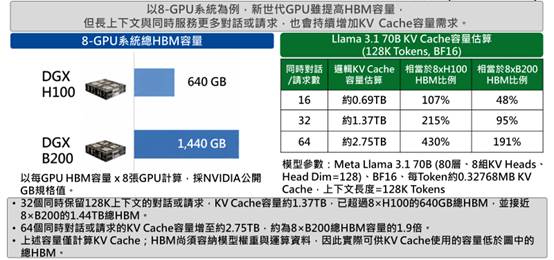
在大型語言模型(LLM)推論過程中,模型權重所需佔用的記憶體容量相對固定,然而 KV Cache 的規模會隨著輸入上下文長度及同時發起之請求數量呈倍數擴增。在每張 GPU 配備的高頻寬記憶體(HBM)容量受到硬體規格上限限制的情況下,高負載場景下的動態資料往往快速逼近 HBM 總量極限。
根據伺服器架構分析,當推論服務處理極長文本時,動態累積的 KV Cache 邏輯容量甚至可能超越標準 8-GPU 系統所配置的 HBM 總和。若單純依賴昂貴且容量受限的 HBM,將導致部署成本劇增並限制伺服器的吞吐量。因此,將推論資料依據存取頻率進行分層配置(Tiered Memory Configuration)成為架構設計的重要方向。
通用 CXL 記憶體擴充技術路徑
為克服傳統 CPU 主記憶體(DIMM)插槽與走線擴充受限的問題,CXL 技術提供了直接擴增可定址記憶體容量的標準化介面:
- CXL Type 3 裝置:主要用於增加主機處理器可定址之記憶體空間,在現有本機記憶體之外提供高容量補充。
- CXL Switch 與記憶體池化:透過交換器(Switch)建立共享記憶體池(Memory Pooling),實現多主機動態分配記憶體資源,大幅提升資料中心整體記憶體利用率。
通用型 CXL 記憶體架構目前以常規雲端工作負載與 CPU 主記憶體擴充為主要既有部署用途,並已在部分超大規模資料中心展開實體導入;相較之下,AI 推論端則以 KV Cache 保存、卸載與重載為新興驗證情境,仍處於特定架構測試階段。
雲端服務商與晶片業者佈局進度
全球主要資料中心營運商與半導體供應商正從不同面向驗證 CXL 在分層記憶體中的可行性:
| 廠商 / 領域 | 發展重心與推進現況 |
|---|---|
| Meta | 已於實際資料中心伺服器環境中部署通用 CXL 記憶體架構。 |
| 微軟(Microsoft) | 持續驗證記憶體擴充、池化(Pooling)及多節點共享技術路徑。 |
| 三星電子(Samsung)與 SK 海力士(SK hynix) | 推進 AI 應用驗證,實測 CXL 記憶體裝置在 KV Cache 儲存與重載的延遲表現。 |
零組件供應鏈與平台工程整合需求
CXL 記憶體生態系已從單一記憶體模組與裝置,延伸至控制器(Controller)、CXL 交換器、以及訊號重計時器(Retimer)等多類伺服器平台元件。隨著實體通道長度增加與高速訊號傳輸要求提升,Retimer 的配置比例顯著增長。
台灣供應鏈廠商主要從高速介面訊號與平台工程切入,例如群聯電子(Phison)藉由長期累積的 PCIe 高速訊號能力進入 CXL 相關市場。此外,由於 CXL 記憶體池化及 Fabric 架構大幅提高平台設計複雜度,伺服器 ODM 業者承擔之系統整合與散熱佈局責任同步加重,硬體客製化能力將成為決定供應鏈工程價值的核心指標。
Reference Link : digitimes.com.tw