

AI 摘要
- 前 OpenAI 研究員創立的 TypeSafe 正式全面開放決策型模型 Jev。
- 該架構捨棄逐字生成文字機制,改以平行取樣直接回傳預設型別結果。
- 模型專門處理軟體系統中的分類、評分與路由等自動化判斷工作。
由前 OpenAI 研究員 Diogo Almeida 創立的人工智慧新創公司 TypeSafe,正式向大眾公開其研發的決策型 AI 模型「Jev」。該模型目前已取消前期的等待名單限制,全面開放所有開發者與企業使用。與當前主流大型語言模型(LLM)專注於文章撰寫、對話互動或程式碼生成不同,Jev 的設計核心在於作為軟體工程管線中的邏輯判斷元件,專門處理分類、路由、評分與分支決策等任務。
跳脫自迴歸架構 改採平行取樣技術
傳統大型語言模型多採用自迴歸(Autoregressive)架構,透過前一個詞元(Token)依序預測並逐字生成下一個詞元。在軟體整合應用中,系統在接收到這類文字或字串後,往往還需透過額外的剖析(Parse)與驗證機制轉為結構化資料,不僅耗費推論運算資源,亦容易增加延遲。
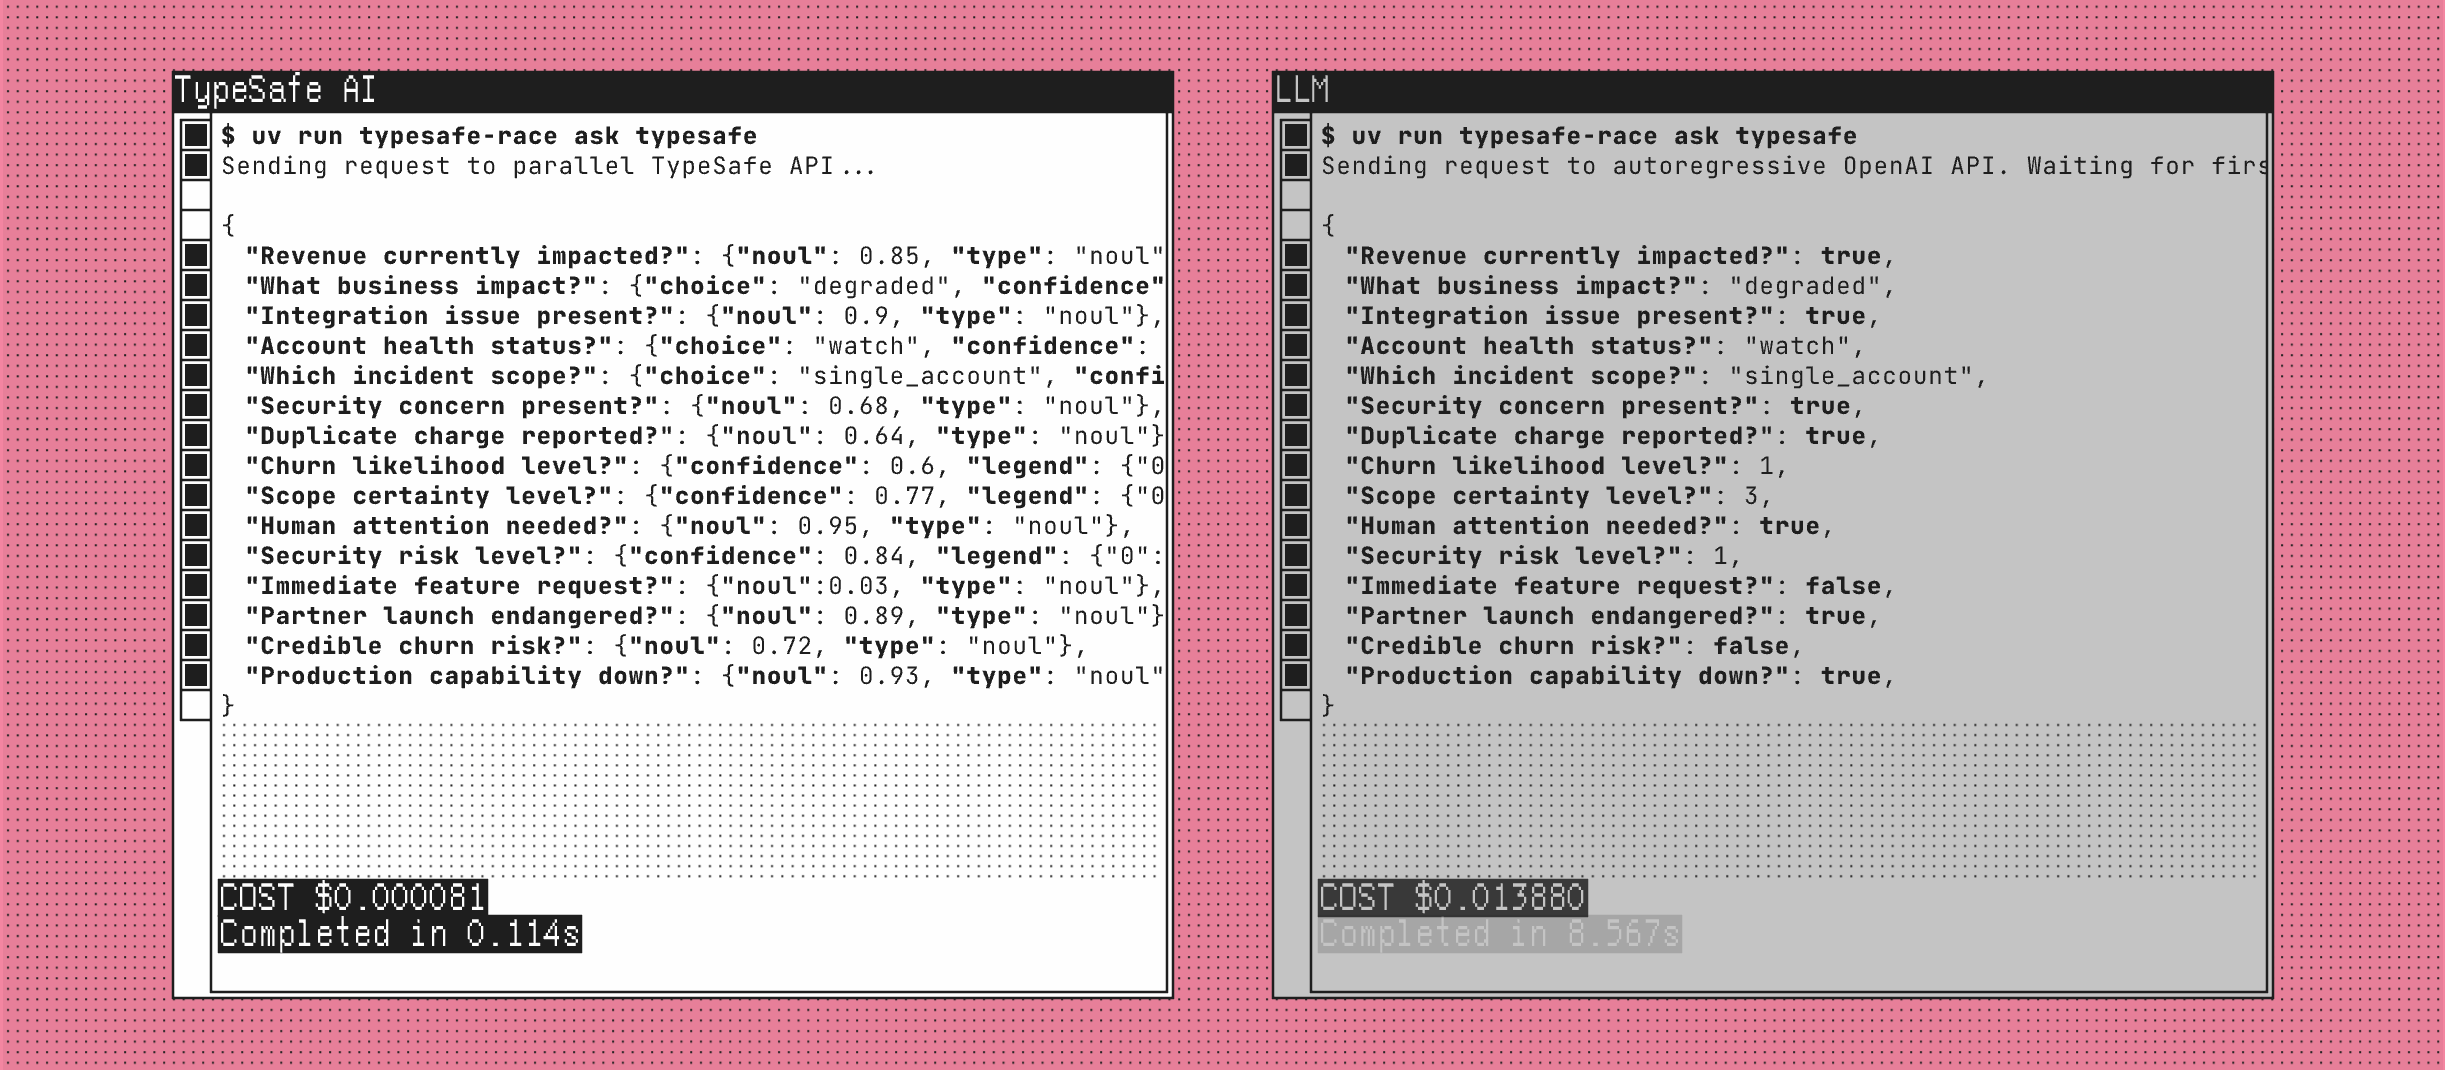
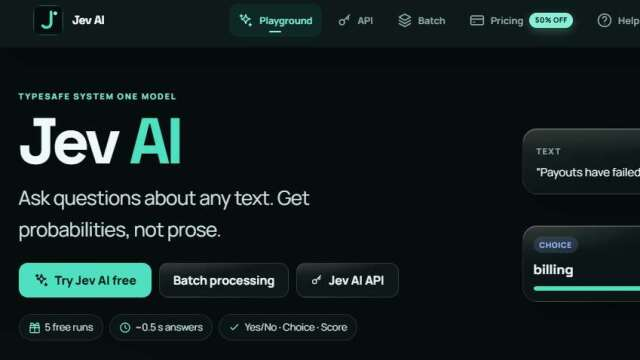
根據 TypeSafe 的說明,Jev 徹底捨棄了逐字生成文字的流程,改採平行取樣(Parallel Sampling)架構,能夠一次性計算多個輸出。開發者在呼叫模型前,需預先定義好允許回傳的資料型別、選項範圍、分數區間或布林(Boolean)機率。模型推論完畢後會直接回傳符合規約的結果,讓後端應用程式能無縫銜接判斷資料,無需再處理繁瑣的字串處理與格式校正。
回應延遲大幅降低 官方實測效能差異顯著
在推論延遲與效能數據方面,TypeSafe 公布 Jev 的端到端回應時間落在 70 至 500 毫秒之間。官方表示,在處理特定決策工作流程時,其運行速度可達部分通用大型語言模型的 40 至 200 倍。
在 TypeSafe 內部建立的工作流程測試中,Jev 甚至記錄到相較通用 LLM 達到 193.6 倍的速度提升,以及 444.6 倍的成本優勢。不過,TypeSafe 亦中立指出,上述近兩百倍的差距屬於極端高效益案例,且測試環境由內部團隊設計,可能存在測試偏差,相關數據並非來自第三方獨立機構的基準測試。
「零幻覺」說法引發討論 型別安全不等於語意正確
TypeSafe 宣稱 Jev 在運作架構上「不會產生幻覺」,其理由在於模型的輸出嚴格受到預設型別系統限制,在結構上不可能回傳超出開發者規範之外的欄位或型別。這項特性在技術社群 Hacker News 上引發廣泛探討。
許多開發者與技術從業者指出,「型別正確」並不代表「語意判斷正確」。即便 Jev 不會輸出格式錯誤的雜訊文字,但在面對邊界案例或複雜語境時,模型依然有可能在合法選項中選出錯誤的答案。因此,社群討論主要聚焦於「不會產生幻覺」的修辭是否過度延伸了型別安全(Type Safety)的定義,以及其與現行 LLM 的結構化輸出(Structured Outputs)或傳統機器學習分類器的本質差異。
鎖定自動化流程 創下 Vercel 整合採用速度紀錄
創辦人 Diogo Almeida 過去曾參與 OpenAI 指令遵循(Instruction-following)模型的相關研究,帶領 TypeSafe 歷經兩年低調研發,於 9 月 15 日釋出 Jev 早期預覽,並於 9 月 21 日正式解除候補名單。Jev 的目標定位非常明確,旨在解決能夠預先界定答案範圍的確定性軟體工程任務,例如將客訴案件自動分流、評估風險評分、篩選內容標籤等即時資料處理場景。
在發布後,雲端部署平台 Vercel 宣布將 Jev 整合進其 AI Gateway 服務。根據 Vercel 公布的數據,在模型上線後的 24 小時內,平台已有接近 13% 的付費團隊啟用該模型,首日導入的團隊數量超過以往任何新模型的 2 倍,創下 Vercel AI Gateway 歷來採用速度最快的紀錄。
Reference Link : ithome.com.tw